빅데이터는 사람이 손으로 다 훑을 수 없어 기계와 통계에 맡기는 데이터입니다 — 관광에서는 대부분 여행자가 무심코 남긴 디지털 발자국입니다.
이 수업은 무엇을 하나빅데이터 분석 = 실전 감각 편 · 데이터 분석 = 이론 기초 편
수업 목표넷입니다.
- How어떻게빅데이터 분석을 할 줄 안다.← 남들이 한 것을 본다 — reference를 유심히 본다 ↓ · Reference 우수작 보기 ↗
- What무엇을빅데이터 분석 역량을 키우기 위해 기초 개념 ↓ · 통계 용어와 공부법 ↓을 익힌다.
- Where어디서실전 감각을 기르기 위해 빅데이터 플랫폼 ↓ · 통계 지표 ↓ · 공모전 수상작 ↓을 직접 찾아본다.
- Who누구에게빅데이터 분석과 이어지는, 접근 가능한 ADsP 자격증 ↓ 취득의 기초(2과목·3과목까지)를 다지고, 이를 지원서의 근거 ↓로 제시할 줄 안다.
Why는 아래 왜 이 수업을 듣나 ↓ · When은 15주 계획표 →
이 수업이 기르는 네 편 — 목표 · 논문 칸 · 링크는 아래 표에
-
1이론왜 · 어떻게
빅데이터란 무엇인가
다섯 걸음으로 분석 설계- 0수상작
- 0.5출처
- 1문제 정의
- 2수집
- 3정제
- 4분석
- 5시각화 · 해석
-
2기술무엇으로
기법 넷을 도구로
Orange · 빅카인즈 · SPSS · 파이썬 · R -
3실전 감각현장에서
물음을 연구 문제로
남의 작품에서 익힌다 · 수상작 서가 ↓
데이터 창구 찾기
의사결정 이야기로 발표 -
4증명남이 알아보게
공모전(분석 증명 포트폴리오)
ADsP 자격증
| 배우는 것 · 편 | 논문으로 보면 | 어디서 하나 |
|---|---|---|
| 빅데이터가 무엇이며, 어디에 있나개념과 5V · 공공 · 민간 창구 · 없을 때 찾는 자리수업에서 쓴 개념빅데이터 개념, 5V(3V · 4V · 7V), 데이터 · 정보, DIKW, 정형 · 반정형 · 비정형, 데이터베이스, KOSIS, 네이버 데이터랩 API | 연구 방법 : 자료 수집 · 분석 프로그램 | 파트 01 빅데이터란파트 02 창구들파트 10 데이터셋 |
| 현장의 물음을 연구 문제로 세우고, 수상작을 뜯어보며 내 분석을 설계한다무엇을 알고 싶은가 — 그 바탕은 이론적 관점과 각 분야의 도메인 지식 다섯 질문으로 읽기(무엇을 물었나 → 어떤 데이터 → 어떻게 맞췄나 → 어떤 기법 → 무엇을 제안했나) 다섯 걸음으로 짜기(문제 정의 → 수집 → 정제 → 분석 → 시각화·해석)수업에서 쓴 개념DIKW 관광 적용, 보행환경(경진대회 사례), 아리랑 비교(밀양 · 정선), 분석 방법, 오픈 API 수집, 경진대회 분석 흐름(보행 소년단) |
서론 · 기존 한계 · 필요성 · 문제 정의 → 이론적 배경 · 연구 설계 · 방법론 | 파트 03 문제 정의파트 03 다섯 걸음수상작 서가 |
| 프로그램 도구를 직접 돌린다기술 통계·시각화 · 텍스트 마이닝·감성 분석 · 군집 분석 · 예측 분석 Orange · 빅카인즈 · SPSS(PC실 가능) · 파이썬 · R수업에서 쓴 개념지도학습, 비지도학습, 군집분석, 텍스트마이닝, 빈도분석, 바이그램, TF-IDF, LDA 토픽, AI 분석, Orange 설치 |
분석 | 파트 04 기법파트 05 도구SPSS · 파이썬 · R노경섭 계층적 군집분석 ▶ 영상 ↗ |
| 결과를 시각화해 의사결정 이야기로 발표한다그래프와 지도로 보여 주고, 결정으로 잇는다 우리가 한 것 — KOSIS 통계를 골라 그래프로 그리고 → DIKW로 풀어 발표 → 그 자리에서 피드백 (9/21 · 9/28)수업에서 쓴 개념KOSIS, 시각화, DIKW, 검색어 트렌드(최고 시점 = 100 상대값) |
결과 · 논의 | KOSIS 실습파트 06 공모전파트 11 현장 |
| 공모전(분석 증명 포트폴리오)과 ADsP로 증명한다실력과 역량을 남이 알아보는 형태로 남긴다수업에서 쓴 개념경진대회 최우수상 사례, 비즈니스 모델, 위기요인 · 통제방안, ADsP 1과목 Q1~37 · 50문항, ADsP 이력서 활용 | 논문 밖 · 성과 | 파트 06 공모전파트 07 자격증ADsP 1과목 지도2과목3과목50문항 실전훈련 판 ↗ADsP 이력서 활용 ↗ |
위 여섯 줄을 한 번씩 해 보고 나면, ADsP 문제에 나오는 말이 이미 써 본 말이 됩니다.
취업면접 · 채용 — 스무 문항과 자리 여섯 곳면접 준비는 학기 중에 시작합니다
기관 인성면접 예상 질문 20문 ↗노란 스티키노트 한 장 ↗워드로 내려받기 ⤓ DOCX
자격증과 분석 실습은 서류를 통과시키고, 면접은 그다음입니다. ADsP도 오렌지 실습도 결국 면접에서 「그래서 무엇을 했고 무엇을 알게 됐는가」로 다시 물어집니다. 아래 스무 문항은 공공기관·공기업 인성면접에서 반복해서 나오는 질문들입니다.
쓰는 법은 하나입니다 — 눈으로 읽지 말고 소리 내어 답하십시오. 한 문항당 40초~1분이 실제 면접의 길이입니다. 스무 장이 자기소개 → 장·단점 → 극복 경험 → 협업과 갈등 → 원칙과 태도 → 마지막 한마디 순으로 놓여 있어, 위에서부터 훑으면 면접 한 회차가 그대로 지나갑니다. 인쇄하면 A4에 4열로 떨어져 손에 들고 연습할 수 있습니다.
실전 입사지원서 — 위 질문에 답할 「내 이야기」를 먼저 종이에 옮깁니다웹에서 바로 작성 · 자동저장 ↗워드로 내려받기 ⤓ DOCX
면접 답은 지원서에서 시작합니다.
- 한 곳 · 한 직무기업·기관 한 곳과 직무 하나를 실제로 고릅니다.
- 자격요건 대조채용공고의 자격요건과 내가 가진 것을 마주 놓습니다.
- 자기소개서 다섯 문항지원동기 · 직무역량 · 문제해결 · 협업 · 입사 후 목표를 상황 → 역할 → 행동 → 결과 흐름으로 씁니다.
- 면접과 이어짐위 스무 문항은 여기 적은 경험을 말로 옮기는 자리 — 지원서가 비면 면접 답도 빕니다.
- 웹 양식칸에 쓰면 브라우저에 자동저장 · 인쇄 · PDF 저장 · TXT 내려받기.
- 워드 양식같은 내용을 손으로 채우는 A4 두 장.
- 제출끝의 자기점검 여덟 줄까지 채우고 냅니다.
왜 이 수업을 듣나지난 공고 · 이런 자리가 열립니다 — 관광 데이터를 분석하는 사람을 국책연구원이 뽑습니다채용 공고 · 한국문화관광연구원 ↗
한국문화관광연구원 위촉직원 채용 공고 [2026-37] — 뽑는 과제 넷 가운데 둘이 관광 데이터를 다루는 자리입니다였습니다. 같은 연구원의 위촉직원 공고는 한 해에도 여러 번 올라오니(올해만 [2026-37] · [2026-38]), 채용 누리집 ↗을 가끔 열어 보십시오.
- 관광산업 특수분류 개정 연구전공 관광학 · 사회학 · 통계학 — 관광산업 분류체계 관련 국내외 자료 분석, 보고서 작성
- 관광거점도시 육성사업 최종성과 분석 연구전공 관광학 · 지역개발 — 도시별 최종성과 분석, 자체 평가 · 성과 관리, 보고서 작성
위촉연구원 1급 · 월 3,048,330원(세전) · 석사, 또는 학사 뒤 연구경력 2년. 지금 바로 낼 자리는 아닙니다 — 대학원이나 연구보조를 거쳐 닿는 자리입니다. 다만 이 수업에서 익히는 말(자료 분석 · 성과 분석 · 보고서)이 공고의 「주요업무」 칸에 그대로 적혀 있습니다.
두 과제 공통 · 이 수업의 파트02 창구03 다섯 걸음04 기법05 도구06 공모전07 자격증진한 셋(02 · 03 · 04)이 두 과제 모두의 핵심

하나 더지난 공고 · 이런 자리가 열립니다 — 데이터를 다루는 연구지원직을 시 · 도 연구원이 뽑습니다채용 공고 · 인천연구원 ↗
인천연구원 연구지원직(데이터관리) 1명 · 정규직 — 인천광역시 출연 연구기관입니다. 이번 공고(9. 7. ~ 9. 22.)는 끝났지만 시 · 도 연구원은 해마다 여러 번 연구직 · 연구지원직을 뽑습니다 — 채용 기회 알림판 ↗에서 다른 기관도 함께 보십시오.
- 하는 일AI · 빅데이터 분석, 데이터사이언스를 활용한 연구과제 지원 — 자료 조사, 통계 · 공간데이터 분석, 보고서 작성
- 전형서류 → 발표자료(PPT 15장 이내) 제출 → 발표면접 → 임용
파트01빅데이터란세 개의 V에 둘을 더한 5V, 데이터가 결정이 되는 DIKW, 지식이 조직 안에서 도는 SECI — 세 모형으로 시작합니다.
① 5V — 데이터가 어떤 모습인가
빅데이터는 흔히 세 개의 V로 설명됩니다. 여기에 둘을 더해 5V라 부르기도 합니다.
- 3VVolume · 양규모가 방대하다.
- 3VVelocity · 속도실시간으로 빠르게 쌓인다.
- 3VVariety · 다양성숫자뿐 아니라 텍스트·사진·위치 등 형태가 제각각이다.
- +2VVeracity · 정확성3V에 더해 5V로 셀 때 함께 꼽습니다.
- +2V · 마지막 관문Value · 가치관광에서는 "데이터가 많다"가 아니라 "그래서 어떤 결정을 바꾸는가"가 마지막 관문입니다.
② DIKW 모형 — 데이터가 결정이 되기까지Data → Information → Knowledge → Wisdom
5V가 데이터가 어떤 모습인가를 말한다면, DIKW는 그 데이터를 어디까지 끌어올렸는가를 말합니다. 한 칸 오를 때마다 양은 줄고 쓸모는 커집니다.
- DDATA 데이터 가공 전의 기록 맥락 없이 쌓인 숫자·글자·신호. 그 자체로는 아무것도 말하지 않습니다. 기지국 신호 한 건, 카드 결제 한 건, 후기 한 줄.
- IINFORMATION 정보 누가 · 언제 · 어디서 · 무엇을 데이터를 정리·집계해 맥락을 붙인 것. 표와 그래프가 여기서 나옵니다. 「10월 주말, 하회마을 방문객은 20~30대가 가장 많다.」
- KKNOWLEDGE 지식 어떻게 · 왜 그런가 여러 정보를 엮어 찾은 패턴과 원인. 다음에도 통하는 규칙입니다. 「축제 주간에 몰리지만 대부분 당일치기로, 저녁 전에 떠난다.」
- WWISDOM 지혜 · 통찰 그래서 무엇을 할 것인가 지식에 판단을 더해 결정과 행동으로 옮기는 단계. 여기까지 와야 가치가 됩니다. 「축제 기간 야간 공연과 숙박을 묶어 하룻밤 더 머물게 한다.」
5V의 마지막 V(Value)는 DIKW의 W에서 생깁니다. 앞으로 배울 수집·정제는 D를 I로, 분석은 I를 K로, 시각화·해석은 K를 W로 끌어올리는 일입니다. 관광 예는 이해를 돕기 위해 만든 가상의 예입니다.
③ SECI 모형 — 지식은 조직 안에서 돈다Socialization → Externalization → Combination → Internalization
DIKW가 데이터를 어디까지 끌어올렸는가(올라가는 계단)라면, SECI는 그 지식이 사람과 사람 사이를 어떻게 도는가(도는 회로)입니다. 몸에 밴 암묵지를 글·매뉴얼·데이터 같은 형식지로 바꾸고, 그것이 다시 누군가의 몸에 붙어 암묵지가 되는 한 바퀴입니다. 분석 과정을 굳이 문서로 남기는 이유가 여기 있습니다.
- SSOCIALIZATION 공통화 암묵지 → 암묵지 같이 겪으며 말 없이 옮겨 가는 단계. 경험과 관찰의 공유입니다. 베테랑 가이드를 따라다니며 어깨너머로 배운다.
- EEXTERNALIZATION 표출화 암묵지 → 형식지 머릿속 요령을 문서 · 매뉴얼 · 데이터로 꺼내 놓는 단계. 남이 볼 수 있게 됩니다. 그 요령을 코스 매뉴얼과 응대 체크리스트로 적는다.
- CCOMBINATION 연결화 형식지 → 형식지 흩어진 형식지를 합쳐 새 지식을 만드는 단계. 분석과 종합이 여기입니다. 지점별 매뉴얼과 데이터랩 방문자 데이터를 합쳐 표준 코스를 짠다.
- IINTERNALIZATION 내면화 형식지 → 암묵지 읽고 해 보다가 제 몸에 붙는 단계. 다시 암묵지가 되어 한 바퀴가 닫힙니다. 신입이 그 표준 코스를 돌다 자기 요령이 생긴다.
내면화로 끝나지 않습니다. 새로 생긴 암묵지가 다시 공통화로 들어가 한 바퀴를 또 돕니다 — 그래서 나선이라 부릅니다. 시험에서는 이 순서를 뒤섞어 묻습니다.
공 → 표 → 연 → 내 (S → E → C → I)
ADsP 1과목에서 Q5(네 단계의 순서)와 Q6(「경험을 문서·매체에 저장·가공한다」 = 표출화)로 나옵니다 — 50문항 실전훈련 판에서 바로 풀어 보기 ↗
파트02관광 데이터는 어디서 오는가관광 빅데이터의 힘은, 여행자가 설문에 답하지 않아도 행동이 저절로 기록된다는 데 있습니다.
- 이동통신 데이터기지국 신호로 본 유동인구·체류시간·방문지 이동 경로.
- 소비카드·결제 데이터어디서 얼마를, 어떤 업종에 썼는가(소비 지도).
- 관심검색·트렌드여행 전 관심의 신호(무엇을 검색하는가).
- 감정SNS·리뷰사진·해시태그·후기에 담긴 감정과 장소.
- 경로내비게이션·위치실제 이동과 정체, 인기 경로.
- 공식공공 데이터관광 통계, 방문객 수, 개방 데이터(data.go.kr, 한국관광 데이터랩 등).
공공 데이터 지도 — 아래 창구 아홉 곳은 모양이 같아 보여도 하는 일이 셋으로 갈립니다. 먼저 층을 보고, 자세한 설명은 아래 카드에서 찾습니다.
통신카드내비게이션 민간 회사가 가진 행동 데이터를 모아 공공이 연다 → ★ 한국관광 데이터랩
위 여섯 카드 중 셋(통신 · 카드 · 내비)은 회사가 가진 데이터입니다. 학생이 직접 받을 수 없는 이 데이터를 한국관광 데이터랩이 모아 지역 · 월별로 열어 줍니다 — 공공 데이터는 정부가 만든 통계만이 아닙니다.
정부 · 공공기관 — 데이터를 가진 곳
- ①원자료 창고원본을 받는다 · 파일 · 오픈 API 공공데이터포털서울 열린데이터광장 기관이 개방한 원자료. 내가 직접 정제해야 합니다.
- ②집계된 지표숫자 표를 받는다 · 표 · 그림 KOSIS 이미 집계 · 검증된 국가 공식 통계. 표를 그대로 씁니다.
- ③분야 특화 플랫폼분석된 결과를 본다 · 비교 · 지도 ★ 한국관광 데이터랩문화소상공인365환경금융혁신보건의료 주제별로 모아 그림까지 그려 둔 곳. 옅은 셋은 주제를 관광 밖으로 넓힐 때.
④민간 · 공공 아님네이버 데이터랩검색 관심도 — 가장 많이 검색된 때를 100으로 둔 상대값. 위 여섯 카드 중 「관심 · 검색·트렌드」의 창구입니다.
이럴 땐 여기 — 기관 이름이 아니라 내 질문에서 출발합니다.
| 강릉의 7월 방문객 · 소비가 궁금하다 | 한국관광 데이터랩③ |
| 관광지 주변 상권 매출을 보고 싶다 | 소상공인365③ |
| 시군구 인구 같은 공식 수치를 표로 받고 싶다 | KOSIS② |
| 관광지 목록 원본 파일 · API가 필요하다 | 공공데이터포털① |
| 서울 한 동네의 생활인구 · 교통을 보고 싶다 | 서울 열린데이터광장① |
| 사람들이 그 여행지를 언제 검색했나 | 네이버 데이터랩④ 민간 |
아래는 곳마다 한 장씩 자세히 — 무엇이 있고, 누가 운영하는지.
- 공공데이터포털(Data.go.kr) ↗ 대한민국 정부·공공기관이 보유한 공공 데이터를 한곳에 모아 파일·오픈API로 제공하는 통합 데이터 포털. 데이터 수집의 출발점.
-
국가통계포털(KOSIS) ↗
인구·경제·사회 등 국가 공식 통계를 검색·시각화·다운로드하는 포털. 공공데이터포털이 기관이 개방한 원자료를 모은 곳이라면, 이쪽은 이미 집계·검증된 지표가 있는 곳입니다 — 표를 그대로 쓰거나 그림으로 받을 수 있습니다.
실습 자료와 판 여섯은 파트 03의 KOSIS 카드에 모아 두었습니다.
-
분야별 빅데이터 플랫폼 ① 관광 · 문화 · 상권
이 모듈에 가장 가까운 셋입니다.
관광(한국관광공사 · 한국관광 데이터랩) — 내내 쓰는 곳. 지역별 · 월별 방문자와 소비를 바로 비교하고 그림 · 표로 내려받습니다. 파트 06 ① 공모전 상자에 자세한 카드가 있습니다.
문화(한국문화정보원) — 관광·숙박·음식·예술·체육·여가 소비 데이터. 관광 데이터랩 다음으로 자주 씁니다.
소상공인365(소상공인시장진흥공단) — 전국 상권·매출·소비를 지도 기반으로 분석. 관광지 주변 상권을 볼 때. -
분야별 빅데이터 플랫폼 ② 환경 · 금융 · 보건의료
주제를 관광 밖으로 넓힐 때 여는 셋입니다.
환경(K-water) — 기상·대기·수자원·생태·화학물질. 기후·생태 관광 연구에.
금융혁신(국민연금공단·전북특별자치도) — 연금·신용·카드 등 금융 데이터. 관광객 카드 소비와 지역별 결제 흐름에.
보건의료(한국보건의료정보원) — 공공 보건의료 데이터 카탈로그·분석센터. 웰니스·의료관광 연구의 참고 자원. - 서울 열린데이터광장 ↗ 서울시가 지속적으로 발굴·개방하는 공공데이터·통계·빅데이터 시각화를 제공하는 서울시 공식 데이터 플랫폼. 관광·교통·인구 등 지역 분석의 출발점.
-
AI-Hub · 외부 데이터 플랫폼 ↗
과학기술정보통신부 · 한국지능정보사회진흥원(NIA)이 여는 AI 학습데이터 창고. 텍스트 · 이미지 · 음성 데이터를 받고, 「외부 데이터 플랫폼」 화면은 교통 · 문화 · 환경 · 산림 · 라이프로그 · 헬스케어 등 분야별 전문 데이터 플랫폼을 한 곳에서 이어 줍니다. 수상작을 보는 곳이 아니라, 어디에 어떤 데이터가 있는지 찾아가는 지도입니다.
관광 적용 — 교통(관광객 이동 · 동선) · 문화(축제 · 지역 콘텐츠) · 환경 · 산림(생태 · 산림관광) · 헬스케어(웰니스 · 걷기) · AI 학습데이터(관광 이미지 분류 · 리뷰 분석 · 챗봇). - 한국과학기술정보연구원(KISTI)의 인공지능 데이터 공유 · 활용 서비스(AIDA)와 연구데이터 플랫폼 DataON. DATA · AI 분석 경진대회와 과학 · 산업 분야의 고급 분석 문제 · 솔루션을 봅니다. 머신러닝 · AI로 문제를 푼 사례로 넓혀 갈 때 여는 곳 — 관광 수업에서는 Dacon · Kaggle 다음 단계입니다.
빅데이터 플랫폼 · 한눈에 여덟 — 데이터를 받는 곳과 남이 만든 수상작 · 코드를 보는 곳을 한 표에 모았습니다.
★ Reference 우수작 보기 → 코드 → 데이터 찾기 → 관광 문제로 → DIKW (8장) ↗
| 플랫폼 | 핵심 기능 | 학생들이 보는 것 |
|---|---|---|
| 서울 데이터 허브 ↗카드 ↓ | 공공데이터 분석 경진대회 | 수상작 · 발표자료 · 시각화 |
| 소통혁신24 ↗서가 ↓ | 정부 · 공공기관 공모전 성과 | 데이터 활용 우수사례 · 수상작 |
| 세종 세담터 ↗서가 ↓ | 지자체 데이터 · AI 경진대회 | 지역문제 해결형 분석 사례 |
| Dacon ↗파트 10 ↓ | 데이터 분석 경진대회 | 데이터 · Python 코드 · 상위 솔루션 |
| Kaggle ↗파트 10 ↓ | 글로벌 데이터사이언스 | 데이터 · Notebook · 코드 · 모델 |
| KISTI AIDA ↗ / DataON ↗카드 ↑ | DATA · AI 문제해결 | AI 분석 경진대회 · 솔루션 |
| AI-Hub ↗카드 ↑ | AI 데이터 + 외부 데이터 플랫폼 연결 | AI 학습데이터 · 분야별 전문 데이터 플랫폼 |
| 공공데이터포털 ↗카드 ↑ | 공공 원자료 제공 | API · CSV · 공공데이터 |
파트03분석은 다섯 걸음으로데이터는 저절로 답을 주지 않습니다. 문제 정의 → 수집 → 정제 → 분석 → 시각화·해석을 거칩니다.
- Reference 보기분석을 시작하기 전에 수상작부터 연다. 무엇을 물었고, 어떤 데이터로, 어떻게 풀었나.수상작 서가로 ↓ 서울 · 보행 소년단 ↓
- 데이터 출처 보기수상작은 어디서 데이터를 받았나. 발표 자료의 「데이터 출처」 장을 본다.볼 것어떤 데이터를 몇 개 겹쳤나 — 출처 이름을 적어 온다우리가 써 본 것KOSIS · 네이버 데이터랩도 그 출처에 있나 찾아본다 KOSIS 카드 ↓ 네이버 데이터랩 ↓
- 문제 정의무엇을 알고 싶은가. (예: 비수기 방문객은 왜 줄어드는가)볼 것수상작은 무엇을 질문 한 문장으로 세웠나
- 수집필요한 데이터를 모은다(공공 API·크롤링·제휴 데이터). 0.5에서 적어 온 출처 이름을 아래에서 찾는다.어디서 받나파트 02 ↓ 공공데이터포털 · KOSIS · 한국관광 데이터랩 · 네이버 데이터랩 · 서울 열린데이터광장 · 분야별 플랫폼 여섯목록과 신청 절차가 거기 있습니다.더 찾을 때파트 10 ↓ 캐글 · 구글 데이터셋 검색 · MDIS · Awesome Public Datasets · 썸트렌드 · 구글 트렌드공공에 없는 것은 여기서 찾습니다.
- 정제(전처리)결측·중복·오류를 걸러낸다. 실무 시간의 대부분이 여기 든다.볼 것기간·지역 단위를 어떻게 맞췄나
- 분석통계·기계학습으로 패턴을 찾는다.볼 것어떤 기법을 썼나 — 파트 04 기법 이름으로
- 시각화·해석그래프와 지도로 보여주고, 결정으로 잇는다.우리가 한 것KOSIS에서 데이터를 보고 → 시각화 → DIKW로 풀어 발표 → 서로 피드백 (9/21 · 9/28) 실습 예제 ↗
-
국가통계포털(KOSIS) ↗
✦ KOSIS 시각화 결과 해석 프롬프트 · 학생용 ↗ 인구관계도 × DIKW 발표자료 · 대본 포함 ⤓ PPTX 100대 지표 × 관광 · 다섯 장 ↗ 100대 지표 아이콘 아틀라스 · 스토리 · 퀴즈 ↗ 그림으로 읽는 KOSIS 스토리 8장 ↗ 내가 말하는 통계 · 역대 수상 영상 ↗인구·경제·사회 등 다양한 분야의 공신력 있는 국가 공식 통계 지표를 검색·시각화·다운로드할 수 있는 통계 포털.
1. 통계시각화콘텐츠 — 인구·물가 등 주요 지표를 차트·지도·웹툰 같은 그림으로 풀어 보여 주는 시각화 모음. 표를 읽기 전에 흐름부터 눈으로 잡을 때 좋습니다. 보는 곳.
2. 데이터 시각화 체험하기 — 통계 데이터를 골라 차트·그래프를 직접 만들어 보는 체험 공간. 코딩 없이 「어떤 데이터에 어떤 그래프가 맞는가」를 손으로 익힐 수 있습니다. 만드는 곳.
3. 실습 예제 — KOSIS 라인 차트 하나(경북 외국인등록인구 2016~2025)를 자료 → 정보 → 지식 → 지혜(DIKW)로 좌우 넘기며 읽습니다.
4. 해석 프롬프트 — 내가 만든 그래프를 AI에게 보여 줄 때 쓰는 질문 틀. 원인을 단정하지 않고 다음에 찾을 데이터까지 묻게 합니다.
5. 내가 말하는 통계 — KOSIS 통계로 만든 역대 수상 영상이 제1회(2014)부터 제13회(2026)까지 연도별로 쌓여 있습니다. 통계를 남에게 보여 주는 형태로 바꾼 실물이라, 바로 아래 디지털콘텐츠 공모전을 준비할 때뿐 아니라 발표 과제의 본보기로도 봅니다.
6. 100대 지표 판 — 100개를 외우지 말고 10개 영역으로 먼저 봅니다(인구 15 · 보건복지 13 · 교육노동 12 · 소득소비 6 · 여가 7 · 주거교통 9 …). 같은 지표를 사람 · 이동 · 관광여가 · 소비 · 산업일자리 · 지속가능성 여섯 질문으로 바꿔 읽고, 마지막 장의 전체 표에서는 관광 · 여가와 이어지는 지표를 파랗게 표시해 두었습니다 — 외래관광객수 · 국내여행 경험률 · 해외여행 경험률 · 문화예술행사 관람률뿐 아니라 고령인구 · 1인가구 · 외국인등록인구 · 근로시간처럼 분석으로 이어지는 것까지 함께 짚습니다. 「빅데이터 분석의 첫 단계는 어떤 데이터가 존재하는지 아는 것」이라는 말이 이 판의 요지입니다.
7. 발표자료(PPTX) — KOSIS 인구관계도 한 화면을 D → I → K → W 네 단계로 올려 보는 열 장. 인구 · 가구구조 변화에서 고령층 맞춤 · 1인 여행 · 체류형 관광이라는 관광 의사결정까지 내려옵니다. 파트 01 5V와의 관계도 한 장 있습니다.
- 퀴즈 · 기술 통계·시각화 · 차트 이해 25문항 ↗ 위 다섯 걸음의 마지막 칸(시각화·해석)을 손으로 확인하는 판입니다. 두 부분으로 나뉩니다 — PART 1(15문항)은 그림을 보고 차트 이름을 맞히고, PART 2(10문항)는 관광 데이터 상황을 주고 어떤 차트가 맞는지 고릅니다. 「무엇을 보여 주려는가」에 따라 차트가 달라진다는 것이 요지입니다 — 비중은 원, 추세는 선, 비교는 막대, 분포는 상자, 관계는 산점도. 25문항을 풀면 점수가 자동으로 매겨집니다. 파트 04 ① 기술 통계·시각화로 넘어가기 전에 한 번 풀어 보면, 그래프를 고를 때 헤매지 않습니다.
2027년 대비국가승인통계 활용 디지털콘텐츠 공모전 — 국가데이터처 2026년(제13회)은 7월 12일 마감 · 끝났습니다
분석 대회가 아니라 콘텐츠 대회입니다. KOSIS의 국가승인통계를 써서 우리 사회의 모습 · 문화 · 일상의 경험을 2분 이내 동영상으로 만들어 내는 자리입니다. 통계를 읽는 데서 끝내지 않고 남에게 보여 주는 형태로 바꾸는 연습이라, 바로 위 KOSIS 카드와 차트 퀴즈에서 익힌 것이 그대로 재료가 됩니다 — 그래프 한 장이 영상의 출발점입니다.
- 무엇을 내나동영상 한 편. 유튜브에 올릴 수 있는 형식(mp4 등) · 720×480 이상 · 2분 이내 권장. 참가 자격은 제한 없음(개인 · 팀 · 단체).
- 심사1차 전문가 40% + 국가데이터처 직원 20%, 2차 누리꾼 투표 40%. 절반 가까이가 공개 투표라, 만든 뒤 알리는 일까지가 준비입니다.
- 시상최우수 1편 120만원권 · 우수 2편 각 60만원권 · 장려 3편 각 30만원권, 모두 국가데이터처장상. 수상하지 못한 팀 중 최대 10팀에도 5만원권이 갑니다 — 완주만 해도 받을 자리가 남아 있습니다.
- 눈여겨볼 조항AI를 썼다면 사용한 프롬프트와 활용 범위를 적어 내야 합니다. 이 수업에서 쓰는 프롬프트 기록이 그대로 제출 자료가 됩니다. 공모전 누리집 「유의 사항」 둘째 항목에 있는 조항입니다 — 같은 자리에 순수창작물 제출 · 표절 시 수상 취소도 함께 적혀 있고, 저작권은 응모자에게 있되 국가데이터처는 우수 작품을 기간 제한 없이 복제 · 전송 · 활용할 수 있습니다.
- 매해 언제 열리나접수는 4월 말~5월 중순에 열려 7월 중순에 닫힙니다(약 두 달). 이어서 7월 말~8월 초 국민 투표, 수상작은 9월 1일 「통계의 날」 행사에서 발표합니다. 2027년 4월에 다시 확인하십시오.
| 회차 · 연도 | 접수 기간 | 수상작 발표 |
|---|---|---|
| 제13회 · 2026 | 4. 30. ~ 7. 12. | 9. 1. 통계의 날 |
| 제12회 · 2025 | 5. 1. ~ 7. 13. | 9월 1일 무렵 |
| 제11회 · 2024 | 5월 중순 ~ 7월 중순(확인 필요) | 8. 30. 통계의 날 기념식 |
| 제10회 · 2023 | 5. 15. ~ 7. 16.(확인 필요) | 9. 1. 통계의 날 |
파트04대표 분석 기법기술 통계 · 텍스트 마이닝 · 군집 분석 · 예측 분석 넷을 보고, 그 아래 실제 사례로 잇습니다.
핵심그림이 다른 것은 누가 틀려서가 아니라, 무엇을 강조하느냐가 달라서다
데이터마이닝은 「무엇을 찾을까」, 머신러닝은 「어떻게 배울까」, 빅데이터는 「무엇으로」, AI는 「어디까지」 — 네 말은 같은 층의 상자가 아니라 서로 다른 질문에 대한 답이라, 그림마다 경계가 달라 보입니다.
| 말 | 무엇에 대한 답인가 | 한 줄 | 관광 예 — 호텔 리뷰 10만 건 |
|---|---|---|---|
| 데이터마이닝 | 목적 — 무엇을 발견하나 | 데이터 속 패턴 · 규칙 · 무리를 찾는다 | 「불만이 어떤 주제로 모이나」를 찾는 일(텍스트 마이닝) |
| 머신러닝 (딥러닝 포함) | 방법 — 어떻게 학습시키나 | 데이터로 규칙을 스스로 배우는 알고리즘. 딥러닝은 그중 신경망을 깊게 쌓은 한 방법 | 그 주제를 묶는 LDA · 군집 알고리즘 |
| 빅데이터 | 재료 — 무엇으로 | 사람이 다 훑을 수 없는 양 · 속도 · 다양성(파트 01의 5V ↑) | 리뷰 10만 건 |
| AI | 목표 — 어디까지 | 사람처럼 판단 · 행동하는 시스템 | 찾아낸 불만에 자동으로 답하는 챗봇 |
확인 질문「우리 도시 관광 앱 후기에서 불만 주제를 찾는다」 — 여기서 빅데이터 · 데이터마이닝 · 머신러닝 · AI는 각각 무엇인가?
①큰 그림 — 데이터마이닝 · 머신러닝 · 빅데이터 · AI
데이터마이닝은 AI 안에 있나, 옆에 있나? — 그림마다 다르게 그립니다. 왜일까요?


그림을 누르면 크게 열립니다
②더 볼 자료 — 열여섯 장
- ▶ 데이터 마이닝 · 텍스트 마이닝 · 머신러닝 · 딥러닝 — 무엇이 다른가 · 좌우 넘김 (16장) ↗ 다음 시간에 봅니다. 네 말을 「무엇을 발견하나(마이닝)」와 「어떻게 학습시키나(머신러닝 · 딥러닝)」로 가르고, 호텔 리뷰 10만 건 하나로 왜 이것은 텍스트 마이닝 · 머신러닝 · 딥러닝인가를 이유와 함께 짚습니다 — 단어 빈도 · TF-IDF는 텍스트 마이닝, 정답을 붙인 긍 · 부정 분류(Logistic · SVM)는 머신러닝, BERT 감성분석은 딥러닝, 관광객 K-means 군집은 비지도학습. 「감성분석 = 딥러닝」이 아닙니다 — 감성분석은 목적이고, 쓰는 방법에 따라 갈립니다. 끝에 한 장 압축표와 퀴즈 여섯 문항(누르면 바로 정답).
데이터 마이닝과 머신러닝 — 지도학습 · 비지도학습
③지도 vs 비지도 — 정답을 주느냐, 안 주느냐
아래 네 기법 가운데 ③ 군집 분석과 ④ 예측 분석은 사실 머신러닝의 서로 다른 갈래에 놓입니다. 정답(레이블)을 미리 알려주고 학습시키는 것이 지도학습 — 분류와 회귀가 여기 속하고, ④ 예측 분석이 그 예입니다. 정답 없이 데이터의 특징만 보고 비슷한 것끼리 스스로 묶게 하는 것이 비지도학습 — 군집분석과 차원축소가 여기 속하고, ③ 군집 분석이 그 예입니다. 이 영상에서 두 방식의 차이를 그림으로 짚습니다.
- 머신러닝 빅데이터 분석 — 지도학습·비지도학습 ↗ 인공지능·머신러닝·딥러닝의 관계에서 출발해, 사람이 규칙을 정하는 전통적 프로그램과 데이터로 규칙을 학습하는 머신러닝의 차이를 짚습니다. 이어 지도학습과 비지도학습의 장단점, 분류와 회귀의 구분(범주를 맞히면 분류, 숫자를 예측하면 회귀), 그리고 모델 학습에서 나타나는 과소적합·과대적합과 그 개선 방법까지 차례로 다룹니다.
- 기술 통계·시각화평균·분포·추세를 요약하고 지도·그래프로 보여주기. 가장 먼저, 가장 자주 쓰인다.
- 텍스트 마이닝·감성 분석후기와 SNS의 단어를 세고(워드클라우드), 긍정/부정을 판정해 "무엇이 만족을 만드는가"를 읽는다.
- 비지도학습군집 분석 (Clustering)비슷한 여행자를 묶어 유형을 만든다(예: 미식형·휴양형·액티비티형) → 맞춤 상품의 근거.
- 지도학습예측 분석 (Prediction)과거 패턴으로 미래 수요를 내다본다 → 성수기 대비, 인력·재고·가격 조정.
- 사례 논문 · 텍스트 마이닝 · 밀양아리랑과 정선아리랑의 온라인 텍스트 재현 양상 비교 ⤓ HWP ② 텍스트 마이닝을 관광에 그대로 쓴 사례입니다. 네이버 검색 API로 두 아리랑의 관련 문서를 모으고, 빈도분석 → 이항결합어(바이그램) → TF-IDF → LDA 토픽모델링으로 무엇이 함께 이야기되는지 읽은 뒤, 네이버 데이터랩의 검색 추이로 두 지역의 관심도를 견줍니다. 결과는 같은 무형문화유산인데도 온라인에서 재현되는 모습이 갈립니다 — 밀양아리랑은 축제 · 캠핑 · 천문대 · 영남루 · 밀양강처럼 관광시설과 체험에, 정선아리랑은 시장 · 열차 · 공연 · 먹거리처럼 전통시장과 관광교통에 붙습니다. 토픽은 각각 여섯 개, 검색 관심도는 2016~2020년 정선, 2021년 이후 밀양이 앞섭니다. 감성(긍정/부정) 판정까지는 가지 않고 단어 → 주제 구조까지 읽은 판이라, 위 카드의 앞쪽 절반을 그대로 보여줍니다.
④ 군집 분석 — 원논문(군4) · 학술 지식노트(군5) · 통합 강의자료(군6)는 아래 「군집 분석 여섯 걸음」에 모았습니다 ↓
Q&A군1군집분석은 지도학습인가, 비지도학습인가?
Q1. 군집(Clustering) 분석은 지도인가 비지도인가? 계층적(위계적) 군집은?
둘 다 비지도학습입니다.
① 군집분석 = 비지도학습 — 정답(레이블) 없이 데이터끼리 얼마나 비슷한가만으로 무리를 나눕니다. 지도학습은 「이 리뷰는 긍정」처럼 정답을 미리 알려 주고 배우게 하는 것(분류 · 회귀)이고, 군집분석은 「몇 가지 유형이 있을까?」를 데이터가 스스로 드러내게 합니다. 관광 예 — 여행자 지출 · 방문 빈도 · 목적으로 묶어 보니 미식형 · 휴양형 · 액티비티형이 나왔다. 이 이름은 묶은 뒤에 연구자가 붙입니다.
② 계층적 군집 = 이것도 비지도학습 — 군집을 만드는 방식만 다를 뿐, 정답 없이 묶는다는 점은 같습니다.
| 계층적 군집 | 비계층적 군집(K-means 등) | |
|---|---|---|
| 방식 | 가장 가까운 둘부터 하나씩 합쳐 나무(덴드로그램)를 만든다(병합형). 반대로 하나에서 쪼개는 분할형도 있다 | 군집 수 k를 먼저 정하고 중심점을 옮겨 가며 나눈다 |
| 군집 수 | 덴드로그램을 어느 높이에서 자르느냐로 나중에 정한다 | 시작 전에 정해야 한다 |
| 거리 기준 | 연결법 — 단일 · 완전 · 평균 · Ward | 중심점까지 거리 |
| 잘 맞는 자료 | 표본이 비교적 작을 때 | 표본이 클 때 |
노경섭(SPSS) 방식의 흔한 순서 — ① 계층적 군집의 덴드로그램 · 응집계수로 군집이 몇 개가 적당한지 본다 → ② 그 수로 K-means를 돌린다. 두 단계 모두 비지도입니다.
헷갈리기 쉬운 지점 둘
- 군집 결과를 실제 정답과 맞춰 평가한다고 지도학습이 되지는 않습니다 — 학습할 때 정답을 쓰지 않았으니 비지도입니다.
- 군집으로 얻은 유형 이름을 정답으로 삼아 분류 모델을 다시 학습시키면(예: 새 여행자가 어느 유형인지 맞히는 모델), 그 두 번째 단계는 지도학습입니다. 실무에서 「군집 → 분류」로 이어 쓰는 경우가 많습니다.
ADsP「군집분석은 비지도학습」 · 「계층적(병합 · 분할 / 연결법 · 덴드로그램) vs 비계층적(K-means — k를 미리 지정)」 — 두 가지가 단골입니다.
Q2. 그럼 군집분석 중에도 지도학습은 없나?
정확히 말하면 군집분석에는 지도학습이 없습니다. 정의 자체가 「정답 없이 묶는 것」이라, 정답을 주고 나누면 그때부터는 분류라고 부릅니다. 다만 경계에 있는 것이 둘 있습니다.
- 준지도(semi-supervised) 군집 — 정답을 「조금만」 쓰는 군집. 제약 군집: 「이 두 리뷰는 반드시 같은 무리(must-link)」 · 「이 둘은 절대 같은 무리가 아님(cannot-link)」처럼 몇 쌍만 정해 줍니다. Seeded K-means: 정답을 아는 몇 개를 처음 중심점(씨앗)으로 씁니다. 관광 예 — 리뷰 1만 건 중 50건에만 「교통 불만」 · 「청결 불만」 표시를 달고 나머지를 묶게 합니다. 연구에서는 쓰이지만 ADsP · 기본 수업 범위 밖입니다.
- 「지도 군집(supervised clustering)」이라는 말 — 논문에 가끔 나옵니다. 정답 범주가 한 무리에 순수하게 모이도록 묶는 방식이라 사실상 분류에 가깝습니다. 드물게 쓰는 말이라 시험 · 수업에서는 쓰지 않는 편이 안전합니다.
가장 많이 헷갈리는 짝 — k가 들어간 두 기법
| K-means | k-NN(k-최근접 이웃) | |
|---|---|---|
| 종류 | 군집 · 비지도 | 분류 · 지도 |
| k의 뜻 | 만들 무리의 수 | 참고할 가까운 이웃의 수 |
| 정답 | 없음 | 이웃의 정답(레이블)을 보고 다수결 |
한 줄 정리정답 없이 묶으면 군집(비지도), 정답을 주고 나누면 분류(지도), 정답을 조금만 주고 묶으면 준지도 군집.
④군집 분석 여덟 걸음 — 갈래 → 유형 → 준비 → 사례 → 글에 적용 → 설명 → 우선순위 → 복습
- 군1갈래지도인가 비지도인가 — 비지도 (위 Q&A)
- 군2유형계층적 · K-means · DBSCAN · 혼합분포 · SOM — 몇 가지인가
- 군3준비거리를 재기 전 Z점수 표준화 (37장)
- 군4사례계층적 → K-means → ANOVA를 이어 쓴 원논문
- 군5글에 적용리뷰를 벡터로 바꿔 K-means vs DBSCAN · 12장 학술 지식노트
- 군6설명같은 논문으로 푼 통합 강의자료 · SPSS vs Orange
- 군7우선순위K-means · Ward · DBSCAN · GMM — 먼저 볼 네 가지
- 군8복습덤문제 3제로 바로 확인
유형군2군집분석은 몇 가지인가 — 한눈에 보기
군집분석의 유형은 몇 가지인가? — 한눈에 보기 (모두 비지도학습)
| 계층 구조 기준 | 작동 원리별 유형 | 대표 알고리즘 | 데이터를 묶는 기준 | 군집 수 결정 | 이상치 처리 | 관광 분야 활용 사례 |
|---|---|---|---|---|---|---|
| 계층적 | ① 응집형 | 병합형, 연결법(최단 · 최장 · 평균 · 중심 · Ward) | 가까운 개체·군집부터 단계적으로 합쳐 덴드로그램 | 덴드로그램을 보고 결정 | 대체로 약함 | 관광객 선호도에 따른 단계적 유형 탐색 |
| 계층적 | ② 분할형 | DIANA | 전체 집단에서 시작해 단계적으로 나눔 | 분할 단계에서 결정 | 대체로 약함 | 관광시장을 큰 집단에서 세부 집단으로 구분 |
| 비계층적 | ③ 분할 기반 | K-means · K-medoids · K-modes | 중심점 · 대표 관측치 · 최빈값 기준으로 배정 | k 사전 지정 | K-medoids는 상대적으로 강건, K-means는 민감 | 여행자 1만 명을 미식 · 휴양 · 액티비티형 셋으로 |
| 비계층적 | ④ 밀도 기반 | DBSCAN | 밀집된 점은 묶고 고립된 점은 노이즈로 구분 | 데이터·모수에 의해 형성 | 노이즈 탐지 가능 | 관광객 GPS 점으로 핫플레이스 찾기 |
| 계층 정보 활용 | ④' 밀도 기반 확장 | OPTICS · HDBSCAN | 밀도 변화와 계층/도달가능성 구조를 활용 | 데이터·설정에 따라 추출 | 노이즈 탐지 가능 | 밀도가 다른 관광지의 방문 집중구역 발견 |
| 비계층적 | ⑤ 모형(분포) 기반 | 혼합분포군집(가우시안 혼합 · EM) · 잠재계층분석 | 몇 개의 확률분포에서 나왔다고 보고 확률로 소속 | 후보 모형 비교 등(정보기준 BIC)으로 선택 | 모형에 따라 다름 | 「이 여행자는 휴양형일 확률 70%」 |
| 비계층적 활용* | ⑥ 신경망 기반 | SOM(자기조직화지도) | 비슷한 것끼리 2차원 지도 위 가까운 칸에 | 지도 크기 설정, 필요 시 후속 군집화 | 별도 처리 필요 | 관광 상품 유형을 한 장의 지도로 펼치기 |
| 비계층적 활용* | ⑦ 격자 기반 | STING · CLIQUE | 공간을 칸(격자)으로 나눠 칸끼리 묶음 | 격자 설정·데이터에 좌우 | 방법·설정에 따라 다름 | 대규모 위치 데이터를 빠르게 요약 |
헷갈리기 쉬운 이름
- 계층적 분할형(Divisive)과 비계층적 분할 기반(Partitioning)은 이름이 비슷하지만 서로 다른 개념입니다 — ②와 ③을 혼동하지 않도록 주의합니다.
- HDBSCAN은 밀도 기반이면서 계층 구조도 함께 활용해 두 축에 걸칩니다. SOM은 차원 축소·시각화 목적으로도 쓰여 군집을 얻으려면 후속 처리가 필요할 수 있습니다.
- 「이상치 처리」는 일반적 경향이며 알고리즘·설정에 따라 달라집니다.
함께 알아 둘 것
- 하드 / 소프트 — ①·②·③·④는 한 무리에만 속합니다(하드). ⑤ 모형(분포) 기반과 Fuzzy C-means는 확률 · 정도로 여러 무리에 속합니다(소프트).
- SPSS 2단계 군집(TwoStep) — 숫자형 · 범주형이 섞인 자료용이고, 군집 수를 자동으로 제안합니다.
- 수업 자료의 위치 — 노경섭 방식은 ①·② 계층적 → ③ K-means 순서로 다루고, 군5 학술 지식노트(K-means vs DBSCAN)는 ③ vs ④ 비교입니다.
한 줄 정리 — 가까운 순서로 합치면 계층적, 개수를 정해 나누면 K-means, 빽빽한 곳을 찾으면 DBSCAN, 확률로 나누면 혼합분포, 지도로 펼치면 SOM.
준비군3거리를 재기 전에 — 단위를 맞춘다
군3▶ 군집분석 × Z점수 표준화 — 학생용 · 핵심 문구 노란 하이라이트 · 퀴즈 8문항 (37장) ↗왜 표준화해야 거리가 공정해지나 — SPSS Z점수 저장 · 관광객 A · B 거리 계산 · 표준화 전후 그림 · 퀴즈
- 군4사례 논문 · 군집 분석 · 유아교사의 공감능력 군집유형에 따른 창의적 인성과 놀이지원효능감의 차이 ⤓ PDF 군집 분석의 원논문 사례입니다 — 아래 군6 통합 강의자료가 이 논문을 사례로 씁니다. 유아교사 241명(2024년 2~3월, 서울·경기·경상)의 공감능력을 하위요인 넷(관점 취하기 · 상상하기 · 공감적 관심 · 개인적 고통)으로 나눈 뒤, 위계적 군집분석으로 군집 수를 잡고 K-means로 확정하는 두 방법을 이어 쓰는 전형을 보여 줍니다. 그렇게 나온 네 유형이 균형형 · 정서적 소진형 · 이상적 공감형 · 인지-정서 불균형이고, 유형별 차이는 일원분산분석(ANOVA)으로 검정합니다 — 묶는 것은 군집분석, 묶은 뒤 차이를 따지는 것은 ANOVA라는 역할 분담이 한눈에 보입니다. 관광에서도 똑같이 씁니다: 여행자를 「만족도 몇 점」 하나로 보지 않고 여러 항목의 조합으로 묶어 유형을 만든 뒤, 유형별로 소비·체류가 다른지 검정하는 순서입니다.
- 군5📘 학술 지식노트 — 개념에서 적용까지 (12장) ↗ 군집 분석을 글(리뷰)에 쓰면 무엇이 달라지나. 텍스트는 먼저 수치 벡터(TF-IDF · 임베딩)로 바꿔야 군집화할 수 있습니다. 다음 시간에 봅니다. 학습목표 넷(개념 · 분석 · 비교 · 적용)으로 시작해 정형 · 비정형 데이터, TF-IDF · 임베딩 → K-means · DBSCAN → 군집 해석, 두 군집 방법의 비교 그림, 관광 리뷰 적용 · 선행연구 · 키워드 퀴즈까지 열두 장으로 넘겨 봅니다. 파트 맨 위 그림 넷, 아래 「열여섯 장」과 함께 보면 좋습니다.
- 군6군집분석 · ANOVA · Orange — 학생 설명용 통합 강의자료 ↗ 군집 분석을 수업에서 어떻게 설명하는지 한 문서로 묶은 판입니다. 위 군4 논문을 사례로 씁니다. 시작은 한 문장입니다 — 「공감능력 80점인 두 사람은 같은 사람일까?」 같은 총점이어도 하위요인의 조합이 다르면 다른 유형이라는 것, 그것이 군집 분석이 필요한 이유입니다. 이어 K-means · 위계적 군집분석 · 요인분석 · ANOVA 넷을 한 표로 구분하고(무엇을 묶는가 · 언제 쓰는가), 비지도학습이라는 갈래에서 SPSS와 Orange가 각각 어디에 강한지, 관광빅데이터 수업에서는 왜 Orange를 쓰는지까지 갑니다. 위 ④ 예측(지도학습)과 짝을 이루는 자리이고, 파트 05 도구의 Orange 설명으로 그대로 이어집니다.
- 군7▶ 핵심 4가지 학습 우선순위 · 그림 — K-means · Ward · DBSCAN · GMM (5장) ↗ 위 ②유형 표의 여덟 갈래 중 먼저 볼 네 가지만 추립니다. K-means · Ward · DBSCAN · GMM을 SVG 개념도로 그리고, 별점으로 학습 우선순위(핵심 4개 · 심화 3개)를 매깁니다. 「관광객을 몇 개로 나눌까(K-means) · 어떤 단계로 합쳐질까(Ward) · 어디에 몰려 있을까(DBSCAN) · 속할 확률은(GMM)」 네 질문으로 알고리즘을 고르는 법까지 다룹니다.
- 군8✏ 계층적 군집분석 덤문제 3제 풀이 ↗ 위 ②유형 표를 세 문제로 바로 확인합니다. 비지도학습 구분 · K-means의 장단점 · 응집형 계층적 군집화를 ADsP 기출 형식으로 묻고, 그림으로 원리를 설명한 뒤 마지막 장에서 복습 퀴즈 3문항을 직접 풀어 즉시 채점합니다.
파트05분석에 쓰는 도구·프로그램앞의 기법들은 결국 도구로 실행됩니다. 관광 데이터 분석에서 자주 쓰는 프로그램을 친숙한 것부터 봅니다.
| 도구 | 무엇을 하는가 |
|---|---|
| 엑셀(Excel) | 가장 친숙한 출발점. 피벗테이블·기초 통계·간단한 그래프까지, 이것만으로 충분한 경우도 많다. |
| SPSS | 메뉴를 눌러 기술통계·t검정·회귀·요인·군집분석까지. 설문 분석의 표준이며, 수업 PC실(2106호)에서 쓸 수 있다. |
| Orange 코딩 없는 머신러닝 | 위젯을 선으로 이어 전처리 → 군집 · 예측 → 시각화까지. 무료 오픈소스이고, 엑셀과 파이썬 사이를 메운다. 이 수업의 첫 분석 도구.내려받기 ↗시작하기 ↗위젯 목록 ↗▶ 공식 영상 강좌 ↗교재 · Orange와 머신러닝 소프트웨어 →군집분석 · ANOVA · Orange 강의자료 ↗교재 · Orange Data Mining과 머신러닝 소프트웨어 이해 →담은 것 — 위젯을 선으로 잇는 것만으로 분석 흐름이 눈에 보인다는 점을 학생에게 설명하는 법, 머신러닝과 딥러닝 소프트웨어의 구분, 비용 · 코딩 부담 · 가시성 비교표, SAS는 구 모델인가라는 물음, 그리고 「PCA · 군집분석은 SPSS에도 있는데 Orange와 무엇이 다른가」. 파트 04의 군집 · 예측 분석을 직접 돌려 보고 싶을 때 첫 도구로 권할 만합니다. 학습 가이드 · ChatGPT 대화 정리 → |
| SQL | 데이터베이스에서 원하는 자료만 뽑아내는 질의 언어. 공공 데이터·PMS 같은 대형 데이터에선 필수. |
| 파이썬(Python) | 사실상의 표준. pandas로 정제, scikit-learn으로 기계학습, matplotlib로 시각화까지 한 언어로. |
| R | 통계와 텍스트마이닝(감성 분석)에 강한 언어. 학계·조사 분야에서 널리 쓰인다. |
| 시각화 BI 도구 | 태블로(Tableau)·파워BI(Power BI): 코딩 없이 끌어다 놓아 대시보드를 만든다. |
| 텍스트마이닝 도구 | 텍스톰(TEXTOM)·워드클라우드: 후기·SNS 텍스트를 정제하고 의미연결망을 그린다. |
처음부터 파이썬을 배울 필요는 없습니다. 다루는 데이터가 커질 때마다 위 표의 순서대로 한 칸씩 올라가면 됩니다.
그 사이를 메우는 길도 있습니다 — 코딩 없이 블록을 이어 붙여 전처리부터 군집·예측까지 돌려 보는 도구입니다. 엑셀로는 부족하고 파이썬은 아직 부담스러운 단계에서 특히 쓸모가 있습니다 — 위 표의 주황 줄 Orange가 그 도구입니다.
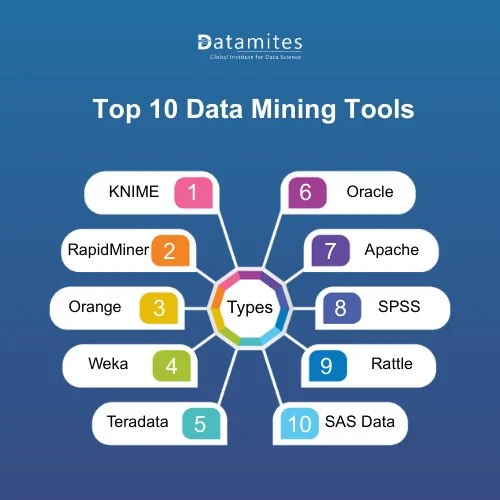
데이터마이닝 도구 10선 — 우리 수업 도구는 어디에?
코딩 없이 블록을 잇는 도구가 Orange만 있는 것은 아닙니다. 세계에서 많이 쓰는 데이터마이닝 도구 열 가지 중 3번 Orange와 8번 SPSS가 이 수업에서 쓰는 도구입니다. 1번 KNIME · 2번 RapidMiner도 Orange처럼 블록을 이어 붙이는 방식이라, Orange에 익숙해지면 쉽게 옮겨 갈 수 있습니다.
Top 10 Data Mining Tools Every Data Scientist Should Know — DataMites ↗
그림 출처 DataMites(누르면 크게 열립니다)
파트06빅데이터 공모전파트 03 다섯 걸음의 0번 Reference 보기가 이 파트입니다 — 맨 앞 수상작 서가부터 열고, 네 대회를 지금 낼 수 있는 것부터 놓고, 대회마다 그 대회가 쓰는 데이터 창구를 바로 아래 붙였습니다.
수상작 서가남이 뽑힌 작품부터 봅니다 여섯 곳 · 다섯 질문 · 과제 한 줄
요강은 「무엇을 내라」이고, 수상작은 「어느 수준으로 내라」입니다. 아래 대회 상자마다 흩어져 있던 수상작 창구를 한자리에 모았습니다. 여섯 곳은 성격이 다릅니다 — 발표자료를 보는 곳, 과정을 듣는 곳, 영상을 보는 곳, 지역 사례를 찾는 곳, 분석 보고를 읽는 곳, 여러 기관의 결과를 두루 훑는 곳. 한 곳만 보지 말고 둘 이상을 나란히 놓아야 「뽑히는 작품의 공통점」이 보입니다.
수상작을 읽는 다섯 질문 — 파트 03 다섯 걸음을 거꾸로 짚습니다. 남의 작품에서 다섯 칸이 채워지면, 내 작품의 빈칸도 보입니다.
- 무엇을 물었나제목 말고 질문 한 문장으로 줄여 적는다. 누가 곤란한 문제인가.
- 어떤 데이터를 겹쳤나출처 이름을 모두 적는다. 한 가지만 쓴 수상작은 드물다.
- 어떻게 맞췄나기간 · 지역 단위를 어떻게 맞췄나.
- 어떤 기법을 썼나파트 04의 기법 이름으로 부른다. 기법이 질문에 맞았나.
- 무엇을 보여 주고 제안했나핵심 그림 한 장과 제안 한 줄. 누가 실행하나까지.
왜 남의 작품부터 보나 — 이 수업이 기르는 셋째 편, 실전 감각 때문입니다. 물음을 연구 문제로 세우고 · 데이터 창구를 찾고 · 의사결정 이야기로 발표하는 것은 교재로 외워지지 않습니다. 수상작 한 편에는 이 셋이 이미 끝까지 해 본 모습으로 들어 있습니다 — 위 다섯 질문 중 「무엇을 물었나」가 연구 문제, 「어떤 데이터를 겹쳤나」가 데이터 창구, 「무엇을 보여 주고 제안했나」가 의사결정 이야기입니다.
- ① 서울시 빅데이터 활용 경진대회 · 수상작 ↗ 2026년 일곱 + 2025년 여섯, 모두 열세 작품에 발표자료 PDF와 대화형 시각화 체험 링크가 붙어 있습니다. 얻는 것 — 발표자료의 목차와 분량. 몇 장으로 문제를 세우고 몇 장으로 결과를 보여 주는지 세어 보십시오. 참가신청서 · 발표 PPT 템플릿도 여기서 받습니다.
- ② 한국관광 데이터랩 · 수상팀 인터뷰 5편 ↗ 우수 활용사례(2024) — 대상 · 최우수 2 · 우수 2. 담당자가 직접 문제 상황 · 해결 방법 · 성과를 말합니다. 얻는 것 — 과정. 결과물만 보면 보이지 않는 「왜 이 데이터를 붙였나」가 말로 나옵니다. 관광 데이터로 뽑힌 작품이라 이 수업에 가장 가깝습니다.
- ③ KOSIS 내가 말하는 통계 · 역대 수상 영상 ↗ 제1회(2014)부터 제13회(2026)까지 국가통계로 만든 2분 안팎의 영상이 연도별로 쌓여 있습니다. 얻는 것 — 숫자를 이야기로 바꾸는 법. 그래프 한 장을 어떻게 첫 장면으로 세우는지 보십시오. 분석 대회가 아니어도 발표 과제의 본보기로 씁니다.
- ④ 부산 빅데이터웨이브 · 분석 우수사례 ↗ 데이터 해커톤 · 분석활용 지원사업 · 분석활용 경진대회 · 창업경진대회의 우수사례가 한 칸에 모여 있습니다. 얻는 것 — 한 도시의 데이터로 어디까지 갔나. 지역 하나를 정해 분석할 때, 남들이 이미 한 주제를 피하고 빈자리를 찾는 데 씁니다. 세종시 세담터도 같은 성격의 수상작 게시판을 둡니다 — 데이터 · AI 활용 경진대회와 빅데이터 분석 아이디어 공모전(2022~2026)이 쌓여 있습니다.
- ⑤ 문화 빅데이터 플랫폼 · 분석사례 ↗ 수상작은 아니지만 본보기로 가장 가깝습니다 — 「소셜에서 뜬 K-드라마 명소, 방문객과 소비가 가장 많았던 곳은?」 · 「반려동반으로 즐기는 여름 휴가지」 · 「숙박이용 데이터로 본 국내 인기 겨울 여행지」처럼 관광 · 문화 주제 분석 25건이 모여 있습니다. 얻는 것 — 질문 한 문장을 제목으로 세우는 법. 제목이 곧 물음이고, 소셜 · 방문 · 소비 데이터를 겹쳐 답합니다. 다섯 질문 중 「무엇을 물었나」 「어떤 데이터를 겹쳤나」를 연습하기 좋습니다.
- ⑥ 소통혁신24 · 2024 데이터 분석·활용 공모전 수상작 ↗ 행정안전부가 연 대회로 아이디어 · 분석 · 우수사례 세 부문, 부문마다 최우수 · 우수 · 장려 둘이 발표돼 있습니다 — 아이디어 부문 최우수는 「데이터 수집·처리 자동화를 통한 온라인 다크패턴 모니터링 업무 효율화」. 소통혁신24는 중앙부처와 지자체의 공모전 결과가 한 게시판에 모이는 곳이라, 같은 자리에서 2025 제천시 데이터 분석 아이디어 공모전 최우수작 「1박 더, 제천 더 : 데이터로 설계한 제천형 체류 관광 전략」도 봅니다. 얻는 것 — 제목 한 줄에 문제 · 방법 · 쓰임을 담는 법. 발표자료보다 수상작 제목 목록이 주로 올라와 있어, 제목만 모아 읽으며 다섯 질문 중 「무엇을 물었나」를 연습하기 좋습니다. 산업통상자원부 공공데이터 활용 공모전의 역대 수상 내역은 데이터콘테스트에 따로 모여 있습니다(마지막 알약).
과제서로 다른 서가에서 수상작 두 편을 골라 다섯 질문에 한 줄씩 답해 옵니다. 맨 끝에 한 줄을 더 — 「내 주제에 가져올 것 하나」.
1마감2026 한국관광 데이터랩 활용 경진대회 — 한국관광공사 9월 30일 접수 마감
이 모듈이 내내 쓰는 그 데이터랩이 여는 대회입니다. 파트 02 「관광 데이터는 어디서 오는가」에서 본 통신 · 카드 · 내비게이션 데이터가 모두 한국관광 데이터랩 한 곳에 모여 있고, 그 데이터로 관광 문제를 풀었거나 성과를 낸 사례를 내는 자리입니다. 아래 부산 대회가 분석 결과물을 낸다면, 이쪽은 데이터를 써서 무엇이 달라졌는가를 냅니다.
- 무엇을 내나관광 데이터를 활용해 문제를 해결했거나 성과를 만든 사례. 아이디어 공모가 아니라 해 본 것을 내는 대회라, 파트 03 다섯 걸음을 한 바퀴 돌린 결과가 그대로 재료가 됩니다.
- 일정접수 2026. 8. 3. ~ 9. 30. 온라인 신청 폼 + 참가서류. 9월 30일로 접수가 닫혔습니다.
- 시상총상금 2,000만원. 문화체육관광부 장관상 · 한국관광공사 사장상이 걸려 있습니다 — 관광 전공자의 이력서에서 무게가 다른 상입니다.
- 먼저 할 것공고 원문에는 부문 구분 · 등수별 상금 · 심사 일정이 적혀 있지 않습니다. 첨부된 「(공모요강) PDF」에 있으니 반드시 내려받아 확인하십시오.
-
한국관광 데이터랩 ★ ↗
이 모듈에서 가장 먼저 열 곳입니다. 파트 02 「관광 데이터는 어디서 오는가」에서 본 통신 · 카드 · 내비게이션 · 관광지 방문객 데이터가 모두 여기 한 곳에 모여 있습니다. 공공데이터포털이 전 분야를 모은 창고라면, 이쪽은 관광만 골라 정리해 둔 곳입니다 — 지역별 · 월별 방문자와 소비를 바로 비교하고 그림과 표로 내려받습니다.
알약 셋(①~③)과 위 상자의 「공고 원문」(④)은 이 순서로 씁니다.
① 지역별 관광 현황 — 시 · 군을 골라 방문자 수 · 체류 시간 · 소비 · 이동을 한 화면에서 봅니다. 배정받은 도시나 내 고향을 넣어 보는 것이 파트 03 다섯 걸음의 첫 걸음입니다.
② 활용 우수사례집 PDF — 「데이터로 만드는 관광 — Next Tourism Playbook」(한국관광공사 관광데이터전략팀, 2025. 11.). 남들이 이 데이터로 무엇을 만들었는지가 사례로 들어 있습니다. 공공누리 4유형이라 출처를 밝히고 쓰되 상업적 이용은 안 됩니다.
③ 수상팀 인터뷰 5편 — 우수 활용사례(2024) 코너입니다. 대상 · 최우수 2 · 우수 2, 담당자가 직접 문제 상황 · 해결 방법 · 성과를 말합니다. 대상은 「데이터로 잡은 전동 킥보드 사고 사각지대」(한국도로교통공단 · 강원랜드) — 관광 빅데이터와 교통사고 통계를 붙인 분석입니다. 사례집이 결과라면 인터뷰는 과정입니다.
노란 알약 · 대상 사례 PM 안전 — 그 대상 사례를 문제 → 데이터 셋(데이터랩 · TAAS · 공유 PM) → 분석방법 다섯 → DIKW → 정책 → 성과로 뜯어 본 판입니다. 끝에 그대로 복사해 쓰는 프롬프트와 상관 · 인과를 가르는 비판적 분석 프롬프트가 붙어 있습니다.
④ 활용 경진대회(위 상자 「공고 원문 · 한국관광 데이터랩」 알약) — 9월 30일 마감(총상금 2,000만원 · 문화체육관광부 장관상). ①로 보고 ②③으로 배운 것을 내는 자리입니다.
22027년 대비2026 서울시 빅데이터 활용 경진대회 — 서울특별시 2026년은 5월 13일 마감 · 끝났습니다
지금 낼 수는 없지만 지금 읽어야 하는 대회입니다. 접수가 3월에 열려 5월에 닫힙니다 — 그때 알면 늦습니다. 부문이 셋이라 이 수업의 산출물과 관광벤처창업론의 사업계획서가 서로 다른 부문으로 들어갈 수 있는 것이 이 대회의 특징입니다.
- 부문 셋창업(아이디어 기획 및 제품·서비스 개발) · 분석(빅데이터 기반 사회문제 해결 또는 비즈니스 모델 발굴) · 시각화(공공데이터 기반 시각화 결과물). 앞의 파트 03 · 파트 04이 분석·시각화에, 관광벤처창업론 사업계획서가 창업 부문에 붙습니다.
- 2026년 일정접수 3. 16.(월) 09:00 ~ 5. 13.(수) 18:00 · 1차 서류 5. 14. ~ 5. 21. · 2차 발표 5. 26. ~ 6. 2. · 최종경연 7. 6.(월) 서울시청 8층 다목적홀. 2027년도 비슷한 일정으로 열립니다.
- 자격과 시상제한 없음 · 개인 또는 최대 5인 팀. 창업 8팀 1,150만원 · 분석 7팀 600만원 · 시각화 7팀 600만원 — 모두 22팀 2,350만원.
- 먼저 볼 것요강보다 수상작입니다. 시각화 부문 페이지에 2026년 일곱 작품 + 2025년 여섯 작품이 발표자료 PDF · 대화형 체험 링크와 함께 걸려 있고, 참가신청서 · 발표 PPT 템플릿도 거기서 받습니다. 요강은 무엇을 내라지만 수상작은 어느 수준으로 내라를 보여 줍니다.
-
서울특별시 빅데이터 캠퍼스 ↗
서울시가 보유한 관광·유동인구·상권 등 대규모 데이터를 검색·분석하고 결과를 반출할 수 있는 공공 분석 플랫폼. 데이터 분석 사례, 강의·자료실, 공모전 등 지원 프로그램도 함께 제공합니다. 이용 신청·데이터 반출 등 일부 기능은 회원가입·로그인 후 이용할 수 있습니다.
경진대회 수상작 · 양식 — 위 상자의 「수상작 · 양식 · 서울 데이터 허브」 알약은 서울 데이터 허브의 시각화 부문 화면입니다. 2026년 일곱 · 2025년 여섯 수상작이 발표자료 PDF · 대화형 체험 링크와 함께 걸려 있고, 참가신청서 · 발표 PPT 템플릿도 여기서 받습니다. 데이터를 받는 곳과 그 데이터로 무엇을 만들어야 하는지가 한 칸에 있습니다.분석 부문 최우수상 「보행 소년단」 발표 — 7분 10초부터 시작합니다. AI가 걸어본 서울 관광지 보행환경을 주제로, 로드뷰 이미지를 멀티모달 AI에 보여 주고 쾌적성 · 보행편의성 · 안전성을 평가하게 한 연구입니다.
이 발표를 다섯 질문으로 — 위 수상작 서가의 질문지를 「보행 소년단」 한 편으로 채워 본 예시입니다. 과제 한 줄은 이렇게 씁니다.
- 무엇을 물었나관광지 주변 어느 길부터 고쳐야 하나 — 역에서 관광지까지의 길도 관광 경험
- 어떤 데이터를 겹쳤나빅데이터 캠퍼스 관광 데이터(관광지 44곳) + 로드뷰 이미지 + 방문객 데이터
- 어떻게 맞췄나관광지마다 반경 400m, 길을 따라 20m 간격 지점, 동서남북 4장을 파노라마 한 장으로
- 어떤 기법을 썼나멀티모달 AI(MLLM) 1~7점 평가 → 크론바흐 α · 사람 평가 비교 → 키워드 · 토픽(약 7개)
- 무엇을 보여 주고 제안했나보행편의성 3.9점이 가장 낮음(안전성 4.8) · 시장·상권형이 약점 → 우선 개선 지도
부산은 이미 이렇게 쓰고 있습니다 — 통신·카드 데이터로 해운대·광안리의 시간대별 혼잡을 읽고, 축제 기간 유동인구를 분석해 안전과 분산에 활용합니다. 감성 분석으로 외국인 관광객의 불편(언어·교통)을 짚어내는 것도 같은 맥락입니다. 아래 대회가 내라는 것이 바로 그런 분석입니다.
32027년 대비2026년 Big Data 활용 대회 — 부산광역시 접수는 9월 18일에 닫혔습니다 · 본선은 10월 29일
이 수업에서 배운 것을 그대로 내는 자리입니다. 부산의 공공 · 민간 데이터와 부산 빅데이터혁신센터 오픈랩 데이터로 지역 현안을 살펴보고, 데이터에 근거한 정책 · 서비스 개선안을 내는 대회입니다. 누구나 개인 또는 1~4인 팀으로 나갈 수 있고 참가비는 없습니다.
- 두 분야① 빅데이터 분석 및 시각화 ② 행정 공유데이터 발굴 및 활용 방안. 앞의 파트 03 다섯 걸음과 파트 04 분석 기법이 ①에, 파트 02 데이터는 어디서 오는가가 ②에 그대로 붙습니다.
- 낼 것 셋보고서(분석 요약 · 분석 결과) · 시각화 결과물 · 분석에 쓴 데이터 파일. 보고서에는 실제로 수행한 분석 과정과 도출한 결과를 적습니다 — 계획이 아니라 한 것을 적는 자리입니다.
- 일정접수 2026. 6. 25. ~ 9. 18.(금) 17:00 · 서류평가 9. 21. ~ 9. 22. · 본선 발표평가 10. 29.(목) 부산 빅데이터혁신센터.
- 몇 팀이 올라가나서류를 통과한 14팀(분석·시각화 10팀 + 행정 공유데이터 4팀)이 발표자료를 만들어 본선에서 발표 · 질의응답을 합니다.
- 시상총상금 650만원 · 1위 300만원. 온라인 접수 · 무료.
-
Big-데이터웨이브 · 부산 공공데이터 ↗
위 ③ 부산 대회가 쓰라고 지정한 데이터가 여기 있습니다. 부산시의 공식 공개데이터 플랫폼으로, 공공데이터 2,796건이 파일 · API · 지도 · 차트 형태로 올라와 있고 분류에 「문화관광」이 따로 있습니다. 데이터를 받는 데서 끝나지 않고 대시보드 · 자체 분석 · 시각화 · 주소 좌표 변환까지 사이트 안에서 됩니다 — 파트 05 도구를 설치하기 전에 브라우저만으로 한 바퀴 돌려 볼 수 있는 곳입니다.
데이터 오픈랩 — 부산 빅데이터혁신센터(센텀기술창업타운)의 안심 분석 공간입니다. 시가 공개하지 않은 데이터와 민간에서 사들인 데이터를 정제해 두는 곳이라, 카탈로그에 없는 데이터는 여기서 나옵니다. 대회 공고가 「오픈랩 데이터」를 함께 쓰라고 적어 둔 이유이고, 본선 발표(10/29)도 이 센터에서 합니다.
분석 우수사례 — 데이터 해커톤 · 분석활용 지원사업 · 분석활용 경진대회 · 창업경진대회의 우수사례를 모아 두는 칸입니다. 부산 데이터로 남들이 무엇을 만들었는지가 여기 쌓입니다 — 위 ③ 대회에 낼 주제를 고를 때 먼저 볼 곳입니다.
쓰는 순서 — ① 카탈로그에서 문화관광으로 좁혀 무엇이 있는지 본다 → ② 우수사례에서 남들이 어디까지 갔는지 본다 → ③ 파트 03 다섯 걸음으로 한 바퀴 돌린다 → ④ 부족한 데이터는 오픈랩 · 데이터 마켓에 있는지 확인한다.
파트07자격증으로 증명하기역량을 증명하고 싶다면 — ADsP · 빅데이터분석기사 · SQLD를 한 표에 놓고 견줍니다.
- 국가기술자격빅데이터분석기사과학기술정보통신부·한국데이터산업진흥원(K-DATA)이 시행. 필기·실기로 나뉘며, 이 분야 취업의 대표적인 관문.통합 비교 →
- 단계별 검증ADsP · ADP데이터분석 준전문가/전문가(한국데이터산업진흥원). 통계·분석 기초부터 심화까지 단계별로 검증한다.ADsP 안내 →1과목 지도 ↓2과목 지도 ↓3과목 지도 ↓50문항 판 ↗
- 실무 기본기SQLDSQL 개발자 자격. 데이터를 뽑아내는 실무 기본기를 인증한다.
- 조사·통계사회조사분석사설문·통계 조사의 설계와 해석. 관광 수요조사와 곧바로 이어진다.통합 비교 →ADsP와 비교 →
어느 자격증부터 손대야 할지 막막하다면, 아래 두 안내 페이지에서 시험 구성·공부기간·연구 활용성을 비교해 보세요.
-
데이터 분석 자격증 통합 비교 — 빅데이터분석기사 중심 →
- 비교 대상빅데이터분석기사(국가기술자격) 중심 · ADsP · PCED · PCAD · 사회조사분석사 2급 — 한 표
- 시험필기 구성 · 실기 유무
- 분석 흐름전처리 → 모델 평가 · Python 예시 코드
- 공부자격증별 현실적인 공부기간 · 시간 대비 효율
- 추천목적별 학습 경로
-
ADsP 데이터분석 준전문가 안내 — 사회조사분석사 2급과 비교 →
- ADsP시험 성격 · 온라인 학습처(국비지원 과정 포함)
- 비교사회조사분석사 2급과 항목별로
- 고르는 기준조사방법론 연구(설문 · 표본추출 · SPSS) ↔ 데이터 분석 연구(전처리 · 회귀 · 군집) — 어느 쪽을 지향하나
ADsP 1과목 지도1장 데이터의 이해 · 2장 데이터의 가치와 미래 · 3장 가치 창조를 위한 데이터 사이언스와 전략 인사이트 윤종식 민트책 32~100쪽 · LMS 1~4주
기억이 가물가물하면 교재 쪽수부터 찾으십시오. 한 줄이 교재의 한 절입니다 — 왼쪽이 교재 쪽 · 배운 주, 가운데가 그 절의 핵심어, 오른쪽이 함께 푼 자료. 핵심어를 먼저 훑고, 설명이 안 떠오르는 절만 엽니다. 알약은 초록 = 개념 노랑 = 기출 순서로 놓았습니다.
1장데이터의 이해 2주 · 2026 예상 약 5문제
- p322주1절 데이터와 정보#DIKW #암묵지·형식지 #SECI #데이터 단위 #정형·반정형·비정형개념 그림 + 기출 클릭형 · 1–5번 ↗
- p382주2절 데이터베이스 정의와 특징#통합·저장·공용·변화 #DBMS #스키마 #메타데이터데이터베이스 6화면 · 기출 6–7번 ↗
- p412주3절 데이터베이스의 활용#OLTP·OLAP #ERP·CRM·SCM #SQL DML #NoSQLSQL DML 여행사 고객표 ↗MongoDB · HBase · Couchbase ↗DBMS 종류 ↗기출 Q8–12 · RDBMS·ODBMS 암기팁 ↗
2장데이터의 가치와 미래 3주 · p51 개괄 · 2026 예상 약 4문제
- p523주1절 빅데이터의 이해#3V·4V·7V #출현배경 #클라우드 #본질적 변화(사전→사후 · 표본→전수 · 질→양 · 인과→상관)3V · 4V · 7V ↗정의 · 출현배경 · 올빼미버스 · 본질적 변화 ↗통합 복습노트 · Value · Veracity · Volatility ↗핵심개념체크 13–17 ↗기출 18–21 ↗
- p57–593주2절 빅데이터의 가치와 영향#가치 산정이 어려운 이유 #기업·정부·개인에 미치는 영향빅데이터로 해결한 사례 8장 ↗기출 22–25 · 2·3절에 걸침 ↗
- p60–633주3절 비즈니스 모델#활용 기본 테크닉(연관규칙 · 유형분석 · 기계학습 …) #맥주와 기저귀데이터마이닝 · 텍스트마이닝 · 머신러닝 · 딥러닝 범주 ↗기출 22–25 뒷부분 ↗
- p64–673주 · 9/144절 위기 요인과 통제 방안#사생활 침해 → 동의에서 책임으로 #책임원칙 훼손 → 결과 기반 책임 #데이터 오용 → 알고리즈미스트 #비식별화위기요인 · 비식별화 기출 26–29 ↗
- p683주 · 9/215절 미래의 빅데이터#데이터 · 기술 · 인력 — 활용의 3요소기출 30–37 · 3장까지 ↗
3장가치 창조를 위한 데이터 사이언스와 전략 인사이트 3주 · p68–79 · 2026 예상 약 1문제
- p68–793주 · 9/21전략 인사이트 · 필요 역량 · 데이터 사이언스의 미래#하드 스킬 · 소프트 스킬 #데이터 사이언티스트 #분석 3요소기출 30–37 ↗
총정리1과목 한 번에 4주
- p—4주핵심개념 · 기출 1~37 통합1장 · 2장 · 3장 문항을 한 파일로 — 시험 직전 한 번에 넘겨 보기 · 2·3장만 볼 때는 13–37본기출 1–37 완전 통합본 ↗기출 13–37 완전 통합본 ↗
- p80–1004주예상문제 50문항1 · 2 · 3장 전체 · 자동채점50문항 실전훈련 판 ↗
곁가지 2주에 함께 본 분석 실습 — 군집분석 · Orange ↗ · SPSS 빈도분석(LMS). 출제 예상 문항 수는 윤종식 교재의 「출제 경향 분석」(2021~2025) 기준입니다.
ADsP 2과목 지도1장 데이터 분석 기획의 이해 · 2장 분석 마스터 플랜 윤종식 민트책 105~187쪽
1장이 2과목 문항의 약 54.5%, 2장이 약 45.5%로 두 장이 고르게 출제됩니다 — 1장에서는 3절 분석 과제 발굴(36.7%)이, 2장에서는 2절 분석 거버넌스 체계 수립(62.6%)이 가장 많이 나옵니다. 용어가 생소해 읽어 두지 않으면 과락 위험이 있다고 교재가 짚는 과목입니다. 왼쪽이 교재 쪽수, 가운데가 그 절의 핵심어, 오른쪽이 함께 푼 자료. 알약은 초록 = 개념 노랑 = 기출 순서로 놓았습니다.
1장데이터 분석 기획의 이해 2021~2025 2과목 문항의 약 54.5%
- PART 021절 분석 기획 방향성 도출#분석기획의특징 #데이터사이언티스트역량(Math&Statistics·IT·DomainKnowledge) #분석대상과방법(Known·Un-Known×Optimization·Insight·Solution·Discovery) #목표시점별기획방안(과제중심·마스터플랜)개념 + 기출 3문제 ↗데이터 분석 기획 시각적 학습 지도 · p106 ↗
- PART 022절 분석 방법론#KDD분석방법론 #CRISP-DM분석방법론 #빅데이터분석방법론5단계 #폭포수·프로토타입·나선형모델 #데이터기반의사결정의장애요소개념 + 기출 5문제 ↗데이터 분석 방법론 표·그림 보존형 교안 · p109–114 ↗빅데이터 분석방법론 이론시각화+기출 · p116–123 ↗
- PART 023절 분석 과제 발굴#하향식접근법4단계 #상향식접근법·프로토타이핑 #체계적문제해결방식 #STEEP거시적메가트렌드개념 + 기출 7문제 ↗분석 과제 발굴 시각화 + 기출 · p124–139 ↗
- PART 024절 분석 프로젝트 관리 방안#정확도Accuracy·정밀도Precision구분 #분석프로젝트주요관리항목 #데이터분석과제프로젝트관리5영역개념 + 기출 3문제 ↗분석 프로젝트 관리 방안 시각화 강의 · 기출 16–18 · p139–144 ↗
2장분석 마스터 플랜 2021~2025 2과목 문항의 약 45.5%
- PART 021절 마스터 플랜 수립 프레임워크#ISP정보전략계획 #적용범위·방식의고려요소 #중장기로드맵수립절차 #분석ROI·우선순위평가기준(3V·4V)개념 + 기출 4문제 ↗분석 마스터 플랜 시각화·4컷만화·기출 19–22 · p145–152 ↗
- PART 022절 분석 거버넌스 체계 수립#데이터거버넌스(원칙·조직·프로세스) #분석성숙도진단3부문(비즈니스·조직·IT) #성숙도단계(도입→활용→확산→최적화) #마스터데이터·메타데이터·데이터사전개념 + 기출 10문제 ↗분석 거버넌스 체계 수립 시각화 강의안 · 기출 10문항(23–32) · p152–167 ↗
2과목 완료 1~2장 전체(6절)를 개념+기출 클릭형 페이지로 정리했습니다. 출제 분포는 윤종식 교재의 「출제 분포와 난이도 분석」(2021~2025) 기준입니다. 절별 쪽수는 아직 정리 중이라 PART 02 범위로만 표시했습니다.
ADsP 3과목 지도1장 데이터 분석 개요 · 2장 R 프로그래밍 기초 · 3장 데이터 마트 · 4장 통계분석 · 5장 정형 데이터 마이닝 윤종식 민트책 192~240쪽
1·2·3장은 3과목 문항의 약 4.5%뿐이라 가볍게 훑고 넘어가도 됩니다 — 나머지 95%는 곧 이어질 4장(통계분석, 약 47%)·5장(정형데이터마이닝, 약 46%)에 몰려 있습니다. 왼쪽이 교재 쪽수, 가운데가 그 절의 핵심어, 오른쪽이 함께 푼 자료. 알약은 초록 = 개념 노랑 = 기출 순서로 놓았습니다.
1장데이터 분석 개요 2026 예상 약 1문제
- p1921절 데이터 분석 기법의 이해#EDA #데이터마이닝 #데이터전처리 #시각화기법 #텍스트마이닝데이터처리·시각화·EDA 개념 + 기출 5문제 ↗데이터 분석 개요 지식 시각화 + 기출 좌우넘김 · p192–197 ↗
2장R 프로그래밍 기초 최근 5년 출제 빈도 매우 낮음
- p198–2191·2절 R 설치·GUI, 입력과 출력#R #RStudio #데이터구조 #벡터 #데이터프레임R 자료구조 개념 + 기출 3문제 ↗R 프로그래밍 기초 시각화 교안 · p198–205 ↗R 데이터 타입·구조·핸들링 · p208–219 ↗
3장데이터 마트 2026 예상 약 4~5문제
- p2211절 데이터 변경 및 요약#데이터마트 #파생변수 #reshape #cast #melt #ddply #plyrDW·DM·파생변수·reshape 개념 + 기출 3문제 ↗데이터 마트 시각화 교안과 기출문제 · p221 ↗
- p2252절 데이터 탐색#이상값 #결측값 #데이터탐색 #상자그림결측값·이상값·상자그림 개념 + 기출 2문제 ↗데이터 탐색(EDA) 인터랙티브 강의 교안 · p224–229 ↗
- p230–240예상문제 20문항1·2·3장 전체 · 자동채점예상문제 20문항 실전훈련 판 ↗1~3장 20문항 문제+해설 동시학습 · 4컷만화 · p230–240 ↗
4장통계분석 268쪽 · 3과목 문항의 약 47%
- p2431절 통계분석의 이해#표본추출방법 #측정척도 #확률 #조건부확률 #이산형확률분포 #연속형확률분포 #표본분포표본추출·확률분포 개념 + 기출 5문제 ↗확률과 확률분포 학습목표·그림해설·기출풀이 · p247–255 ↗통계분석 좌우넘김 이론·문제통합 교안 · p243–245 ↗4장 통계분석 전체 목차·세부 학습목표 · p242–341 ↗
- p2572절① 기술통계#기초통계량 #히스토그램 #상자수염그림 #summary함수기초통계량·그래프 개념 + 기출 3문제 ↗기초 통계분석 시각화 교안 · 자유도(n-1) 만화 · 실전퀴즈 · p255–263 ↗
- p2642절② 추정과 가설검정#중심극한정리 #점추정 #구간추정 #귀무가설 #대립가설 #제1종오류 #제2종오류 #p-value가설검정·오류 개념 + 기출 4문제 ↗추정·가설검정 이론시각화 + 기출 14–21 · p269–271 ↗추정과 가설검정 15장 4컷만화 · 유의수준·신뢰구간 · p264–269 ↗추정과 가설검정 15장 · 신뢰구간 시각화그림 · 기출연계 · p264–269 ↗
- p2722절③④⑤ 범주형 자료분석 · 분산분석 · 실험계획법#분할표 #독립성검정 #오즈비 #ANOVA #실험계획법교차분석·ANOVA 개념 + 기출 3문제 ↗분산분석(ANOVA) 이론 옆 확인문제 · 만화 · p275–276 ↗실험계획법 통합교안 · 18컷 만화 · 기출 25번 · p277–278 ↗범주형 자료분석 4컷만화 · 이론시각화 · 기출 · p271–274 ↗
- p2792절⑥⑦ 비모수검정 · 상관분석#비모수검정 #윌콕슨 #피어슨상관계수 #스피어만상관계수비모수검정·상관분석 개념 + 기출 4문제 ↗비모수검정 전체이론 · 4컷만화 · 기출 26–27 · p279–280 ↗상관분석 이론 시각화 슬라이드 · p280–284 ↗상관분석 기출 28–32 · 암기+4컷만화 · p285–286 ↗
- p2873절①② 회귀분석 개요·가정, 단순선형회귀#회귀분석 #독립변수 #종속변수 #정규성검정 #잔차분석 #결정계수회귀분석 기본·가정·R² 개념 + 기출 3문제 ↗회귀분석 시각화 + 기출 33–36 · p287–290 ↗단순선형회귀분석 이론시각화 인터랙티브 교안 · p291–293 ↗
- p2953절③④ 다중공선성과 회귀진단#다중선형회귀분석 #다중공선성 #F-통계량 #Cook's Distance #잔차정규성VIF·F검정·회귀진단 개념 + 기출 4문제 ↗다중선형회귀분석 시각화 + 기출 38–40 · p295–296 ↗영향력 진단 인터랙티브 시각화 교안 · p297 ↗
- p2993절⑤⑦ 변수선택법과 정규화 회귀#변수선택법 #최적회귀방정식 #AIC #BIC #Lasso회귀모형 #Ridge전진·후진선택, Ridge·Lasso 개념 + 기출 4문제 ↗변수선택법 7개 섹션 4컷만화 · 기출 43·44 · p299–306 ↗회귀분석 결과해석 시각화 · 기출 45–47 · p307–309 ↗정규화 회귀 Ridge·Lasso·Elastic Net · 기출 48 · p310 ↗연속형 모델 성능평가 · 기출 49 · p311–312 ↗
- p3134절 시계열 분석#정상성 #평활법 #시계열모형 #분해시계열 #ARIMA모형 #백색잡음정상성·평활법·ARIMA 개념 + 기출 4문제 ↗시계열분석 이론 시각화 + 기출 50–52 · p313–315 ↗시계열분석 수업목표·핵심개념 + 이론시각화 · p313–315 ↗시계열자료 분석방법 시각화·기출 · p316–317 ↗시계열모형 수업목표·개념정리 · 기출 54–58 · p318–323 ↗
- p3275절 다차원척도법(MDS)#다차원척도법 #유사성 #비유사성 #차원축소MDS 개념 + 기출 2문제 ↗다차원척도법(MDS) 시각화·기출 좌우넘김 교안 · p326–327 ↗다차원척도법(MDS) 좌우넘김 시각화 교안 · p328–331 ↗
- p3336절 주성분분석(PCA)#주성분분석 #고윳값 #Scree Plot #누적기여율 #biplotPCA·고윳값·Scree Plot 개념 + 기출 4문제 ↗주성분분석(PCA) 이론·4컷만화·기출 · p332–333 ↗PCA·SVD 섹션별 4컷만화 · 기출 63 · p334 ↗PCA vs EFA 심화 · 4컷만화·기출풀이 · p335–336 ↗주성분분석 결과해석 시각화 교안 · p337–340 ↗
- p342–3784장 공식 예상문제 62문항교재 부록 · 1절7 2절20 3절17 4절10 5절1 6절7 · 자동채점4장 예상문제 62문항 실전훈련 판 ↗62문제 해설 · 단원별 4컷만화 · 좌우넘김 · p342–368 ↗
- 종합4장 예상문제 40문항1~6절 전체 · 자동채점4장 예상문제 40문항 실전훈련 판 ↗
4장 완료 1~6절 전체를 개념+기출 클릭형 페이지로 정리하고, 교재 부록의 공식 예상문제 62문항까지 자동채점 페이지로 반영했습니다.
5장정형 데이터 마이닝 132쪽 · 3과목 문항의 약 46%
- p3791절 데이터 마이닝의 개요#지도학습 #비지도학습 #데이터분할 #홀드아웃 #k-fold교차분석 #오분류표 #민감도 #특이도 #ROC곡선 #AUC값데이터분할·오분류표·ROC 개념 + 기출 4문제 ↗추진단계 슬라이드 · p377–383 ↗개요 이론+기출 슬라이드 · p377–380 ↗분석방법·추진단계 슬라이드 · p381–382 ↗데이터분할·교차검증 슬라이드 · p383–384 ↗분류모형 성과분석 · p385–392(기출7–12) ↗성과분석 슬라이드 · p385–390 ↗
- p3932절 분류분석 — 로지스틱회귀·KNN·SVM#로지스틱회귀분석 #k-최근접이웃법 #서포트벡터머신 #커널함수로그오즈·KNN·SVM 개념 + 기출 4문제 ↗로지스틱회귀 이론·R·기출 슬라이드 · p396–400 ↗KNN 슬라이드 · p401–403 ↗SVM 슬라이드 · p404–405 ↗나이브베이즈 슬라이드 · p406 ↗Iris 데이터셋 3품종 사진 비교 ↗
- p4083절 의사결정나무 분석#분리기준 #가지치기 #지니지수 #엔트로피분리기준·가지치기 개념 + 기출 3문제 ↗의사결정나무 이론·시각화 슬라이드 · p408–414 ↗불순도 측도 슬라이드 · p415–418 ↗CART·MARS 알고리즘 비교 · p420(기출25) ↗의사결정나무·R실습 슬라이드 · p419–423 ↗
- p4244절 앙상블 분석#붓스트랩 #배깅 #부스팅 #랜덤포레스트 #스태킹배깅·부스팅·랜덤포레스트 개념 + 기출 2문제 ↗앙상블① 배깅·보팅·스태킹 슬라이드 · p424–429 ↗앙상블 슬라이드(보강판) · p424–432 ↗앙상블② 부스팅·랜덤포레스트 슬라이드 · p428–432 ↗
- p4335절 인공신경망 분석#인공신경망 #은닉층 #활성화함수 #드롭아웃 #GAN뉴런·가중치·드롭아웃 개념 + 기출 2문제 ↗인공신경망 슬라이드 · p433–445 ↗퍼셉트론·활성화함수 슬라이드 · p436–439 ↗ANN 모형구축 고려사항 · p440–442 ↗ANN 모형구축 핵심정리 · p440–442 ↗
- p4466절 군집분석#계층적군집분석 #최단연결법 #최장연결법 #덴드로그램 #k-평균군집분석 #Elbow⭐ 쉬운 문제 6선 · 아래 알약들에서 추린 것 ↗연결법·덴드로그램·K-means 개념 + 기출 4문제 ↗군집분석 개요 슬라이드 · p446–466 ↗거리·유사도 측도 슬라이드 · p449–451 ↗계층적군집분석 이론정복 · p452–455 ↗비계층적군집 유형별 특징 · p456 ↗K-means 슬라이드 · p457–458 ↗혼합분포군집·EM알고리즘 · p459–461 ↗자기조직화지도(SOM) · p462–463 ↗최신 군집분석 5기법 · p463–465 ↗군집모형 평가지표(던지수·실루엣) · p466 ↗덤문제 · 군집분석 3문제 풀이 ↗핵심 4가지 우선순위 · 그림(K-means·Ward·DBSCAN·GMM) ↗Orange Distance Map 완전해설(Iris) ↗
- p4677절 연관분석#연관규칙 #지지도 #신뢰도 #향상도 #Apriori알고리즘지지도·신뢰도·향상도 개념 + 기출 2문제 ↗연관분석 슬라이드 · p467–472 ↗연관성분석 동향 슬라이드 · p473–474 ↗Apriori 실습예제 슬라이드 · p475–477 ↗
- 종합5장 예상문제 21문항1~7절 전체 · 자동채점5장 예상문제 21문항 실전훈련 판 ↗
- p478–5095장 공식 예상문제 64문항교재 부록 · 1절13 2절5 3절5 4절5 5절6 6절20 7절10 · 자동채점5장 예상문제 64문항 실전훈련 판 ↗
5장 완료 1~7절 전체를 개념+기출 클릭형 페이지로 정리하며 3과목(데이터 분석) 전 범위 작업을 마쳤습니다. 교재 부록의 4장·5장 공식 예상문제(126문항)까지 모두 자동채점 페이지로 반영해 3과목 작업을 마무리했습니다.
파트08학습 경로 — 무엇을 어떤 순서로 배울까독학이 막막하다면 K-MOOC의 무료 강좌부터. 아홉 갈래로 나눈 지도와 수준·목표별 경로가 있습니다.
K-MOOC 빅데이터 강좌 지도 ↗
K-MOOC의 빅데이터 관련 강좌는 크게 아홉 갈래로 나눠 보면 자신에게 필요한 것을 고르기 쉽습니다. 제목을 누르면 유형별 대표 강좌·학습 형태·마이크로러닝까지 정리한 전체 안내 페이지로 이동합니다.
| 유형 | 배우는 내용 |
|---|---|
| 데이터 분석 입문 | 빅데이터 개념, 분석 절차, 기초 도구 |
| Python·R 프로그래밍 | 데이터 수집·정제·분석·자동화 |
| 데이터 시각화·EDA | 탐색적 분석, 차트, 대시보드 |
| AI·머신러닝 | 예측·분류, 지도·비지도학습 |
| NLP·생성형 AI | 텍스트 분석과 생성모델 |
| 마케팅·비즈니스 | 고객·시장·브랜드 데이터 분석 |
| 공공·지역·부동산 | 공공데이터를 활용한 지역문제 분석 |
| SQL·클라우드·DB | 데이터 저장·조회, 클라우드 분석 |
| 수학·통계 | 확률·통계, 선형대수, 연구 분석 |
유형별 대표 강좌·학습 형태·마이크로러닝까지 한 화면에 정리한 K-MOOC 빅데이터 강좌 안내 페이지도 참고하세요. 구체적인 강좌명·개설 학기는 시기마다 바뀌므로, 아래 K-MOOC 빅데이터 강좌 검색 링크에서 최신 목록을 확인하는 것이 정확합니다.
수준·목표별 추천 학습 경로
- 입문 학생 — 데이터 분석 기초 → EDA·시각화 → 공공데이터 활용
- 논문·연구 중심 — 확률·통계 → R·Python → 고급 데이터 분석
- 관광·마케팅 전공 — AI 마케팅 → 브랜드 데이터 분석 → SQL 마케팅 분석
- AI 실무 중심 — Python·Pandas → 머신러닝 → NLP·생성모델
- K-MOOC — 빅데이터 강좌 검색 ↗ 국가평생교육진흥원이 운영하는 무료 온라인 공개강좌(MOOC). 대학·기관이 개설한 빅데이터·데이터 분석 강좌를 검색해 수강할 수 있습니다.
- K-MOOC 빅데이터 강좌 안내 (자체 제작) → K-MOOC에 개설된 빅데이터 강좌를 9개 유형으로 분류하고, 수준·목표별 추천 학습 경로와 학습 형태(일반·매치업·VOD·마이크로러닝)를 한 화면에 정리한 안내 페이지. 유형 필터로 원하는 강좌만 골라 볼 수 있습니다.
파트09미디어 · 담론 분석뉴스와 소셜 텍스트에서 무엇이 언제 어떻게 이야기되었는가를 읽는 두 도구입니다. 파트 04 텍스트 마이닝을 논문으로 확인하는 자리이기도 합니다 — 카드마다 그 도구로 쓴 실제 논문을 걸어 두었습니다.
-
빅카인즈(BIG KINDS) ↗
① 빅카인즈로 쓴 논문 · ScienceON ↗ ② 숏폼 트렌드 논문 · 원문 PDF ↗ ③ 활용법 · 「여가 만족」으로 따라 해 보기 ↗ ④ 사용법과 검색어를 고르는 감각 ↗ ⑤ 가중치와 기사 건수는 무엇이 다른가 ↗주요 언론사 기사를 분석해 관계도·연관어를 시각화해 주는 뉴스 빅데이터 분석 서비스.
①논문 예시 1 — 오경아 · 나규민(2023), 「빅카인즈를 활용한 '플로깅' 트렌드 분석」, 여가학연구 21(4), 79–98. 2018~2022년 54개 매체 뉴스 5,148건을 빅카인즈 안에서 빈도 · 관계도 · 연관어로 읽고, 도입기 · 발전기 · 확산기로 갈랐습니다 — 다른 도구 없이 빅카인즈만으로 한 편이 됩니다.
②논문 예시 2 — 나규민 · 오세이(2024), 「빅카인즈를 활용한 '숏폼' 트렌드 분석」, 한국여가레크리에이션학회지 48(2), 113–125. 같은 연구진이 같은 절차(54개 매체 · 빈도 · 관계도 · 연관어)를 숏폼에 옮겨 2020~2023년 뉴스 3,518건을 해마다 끊어 읽었습니다 — 틀 하나를 주제만 바꿔 다시 쓰는 법이 보이고, 원문은 로그인 없이 열립니다.
③활용법 판(열 장 좌우 넘김) — 검색어 설계 → 기간 설정 → 연관어 분석 → 관계도 분석을 「여가 만족」 한 주제로 끝까지 따라갑니다. AND · OR · NOT · 구문검색 네 논리를 한 장에서 익히고, 검색조건을 바꿔 기사 건수가 어떻게 달라지는지 비교하게 합니다. 끝에는 연관어 분석과 관계도 분석이 무엇이 다른지(어떤 단어가 함께 나오나 ↔ 등장한 대상들이 서로 어떻게 엮이나)를 갈라 줍니다 — 파트 04 텍스트 마이닝을 손으로 해 보는 자리입니다.
④검색어 감각 판 — 어떤 낱말로 검색할 것인가가 분석의 절반이라는 판입니다. 실제 연구가 「사회적 관심 단어」에서 출발해 문제 제기를 거쳐 최종 방향을 잡기까지를 따라가고, 좋은 검색어의 조건을 세운 뒤 분야별 예(5·18 · 교권침해 · 고교학점제 · 노인학대 같은 사회 분야, AI · 산업 · 미디어 분야)를 놓고 견줍니다. 사건명 · 대상명도 좋은 검색어이되 분석 목적을 구분해야 한다는 대목이 요지입니다.
⑤가중치 판(여섯 장) — 화면에서 바로 바꿔 보게 되는 「기사 건수」와 「가중치」를 가릅니다. 기사 건수는 몇 개의 기사에 나왔나를 사람이 세는 것이고, 가중치는 알고리즘이 계산한 연관성 점수입니다. 그래서 기사 수가 적은 단어가 가중치는 더 높을 수 있습니다 — 학생이 결과표를 보고 가장 자주 틀리는 대목입니다. 내가 정하는 것(검색어 · 기간 · 데이터 유형)과 알고리즘이 정하는 것(점수)을 갈라 두는 것이 이 판의 요지입니다. -
텍스톰(TEXTOM) ↗
수집한 텍스트 데이터를 정제하고 워드클라우드·의미연결망 등 다양한 텍스트 마이닝을 수행할 수 있는 분석 플랫폼.
논문 예시 — 채기웅 · 오경록(2024), 「누리과정 변천에 따른 유아체육 연구 흐름 분석: 텍스톰과 빅데이터의 활용」, 한국체육과학회지 33(6), 425–438. 세 시기의 선행연구를 텍스톰으로 수집 · 정제해 흐름을 비교합니다 — 관광 연구 흐름을 볼 때 그대로 따라 할 수 있는 절차입니다. DBpia 원문은 소속 기관 로그인이 필요할 수 있습니다.
논문 예시 2 — 이명하 · 장윤호 · 김미량(2023), 「N-gram을 활용한 COVID-19 전·중·후 여가 키워드 변화 분석: 2018~2023년 뉴스 기사를 중심으로」, 한국융합과학회지 12(10), 195–207. 왼쪽 빅카인즈로 뉴스 기사를 모으고 텍스톰으로 빈도 · 워드클라우드 · N-gram을 돌렸습니다 — 옆 두 카드를 한 연구 안에서 이어 쓰는 순서가 그대로 보입니다.
논문 예시 3 · 관광 — 최연희 · 유경미(2024), 「소셜 빅데이터를 활용한 한국관광 트렌드에 관한 연구: 감성분석을 중심으로」, 문화기술의 융합 10(3), 97–109. 구글 · 네이버 · 다음의 카페 · 블로그 · 뉴스에서 「한국관광」 「국내관광」을 1년치 모아 텍스톰 6.0으로 키워드 · CONCOR 군집 · 감성분석까지 갔습니다 — 셋 가운데 이 수업 과제와 가장 가까운 본보기입니다.
파트10키워드 · 트렌드 · 데이터셋사람들이 무엇을 검색하고 무엇을 사는지를 숫자로 보는 도구들과, 분석에 쓸 데이터를 구하는 곳입니다. 관심이 언제·어디서 오르내리는지부터 그 관심이 실제 거래로 이어지는지까지 나눠 봅니다.
- 캐글(Kaggle) 데이터셋 ↗ 전 세계 데이터 과학자들이 공유한 방대한 공개 데이터셋을 탐색·다운로드할 수 있는 글로벌 데이터 분석·머신러닝 커뮤니티. 관광·리뷰·트렌드 등 실제 분석 실습용 데이터를 구하기 좋습니다.
-
구글 트렌드(Google Trends) ↗
전 세계 구글 검색 데이터로 특정 키워드의 시간별 관심도 변화 · 지역별 관심도 · 관련 검색어를 확인하는 도구. 여러 검색어를 동시에 비교할 수 있어, 관광지 · 축제 · 트렌드가 언제 · 어디에서 주목받았는지 볼 때 좋습니다. 안동 · 경주 · 부산 · 제주를 한 화면에 놓고 견주는 실습이 바로 됩니다.
아래 블랙키위가 국내 검색 키워드를 파고든다면, 이쪽은 국내와 해외를 함께 봅니다 — 인바운드 관광을 다룰 때 갈라 쓰는 자리입니다. - 아이템스카우트(ItemScout) ↗ 키워드 하나를 넣으면 한 달 검색수 · 경쟁강도 · 실거래 비율 · 평균가격이 한 화면에 나옵니다. 네이버 데이터랩이 「관심이 언제 오르내리는가」를 보여준다면, 이쪽은 「그 관심이 실제 거래로 이어지는가」를 숫자로 보여줍니다. 지역 기념품·체험상품처럼 관광이 상품이 되는 지점을 잴 때 씁니다.
- 판다랭크(PandaRank) ↗ 같은 키워드를 콘텐츠 쪽에서 봅니다 — 검색량과 일 방문자 수를 견줘 그 키워드로 글을 썼을 때 사람이 올지 가늠하고, 블로그 채널의 영향력·신뢰도 지수도 잽니다. 인플루언서 검색도 있어 스마트 투어리즘 06장 홍보와 바로 이어집니다.
- 썸트렌드(Sometrend) ↗ 인스타그램·블로그·뉴스 등 방대한 소셜 데이터를 기반으로 소비자 반응과 최신 트렌드를 AI로 쉽게 분석할 수 있는 소셜 빅데이터 플랫폼.
- 블랙키위(Blackkiwi) ↗ 키워드 검색량 조회·연관 키워드 추출·경쟁 분석을 통해 데이터 기반 마케팅과 블로그 운영을 지원하는 키워드 분석 도구.
분석에 쓸 데이터를 직접 구하고, 실전 문제로 분석 실력을 겨뤄볼 수 있는 대회도 함께 모았습니다.
- 마이크로데이터 통합서비스(MDIS) ↗ 통계청이 각종 통계조사의 원자료(마이크로데이터)를 통합 제공하는 서비스. 가공 전 원본 데이터로 심화 분석을 할 때 유용합니다.
- Awesome Public Datasets ↗ 분야별로 잘 정리된 전 세계 공개 데이터셋 링크를 모아둔 깃허브 큐레이션 저장소. 어떤 데이터가 있는지 한눈에 훑어보기 좋습니다.
- 구글 데이터셋 검색(Dataset Search) ↗ 웹 전역에 흩어진 공개 데이터셋을 키워드로 찾아 주는 구글의 데이터셋 전용 검색엔진.
-
데이터 분석 경진대회 · 3곳
데이콘 — 국내 대표 데이터 분석·AI 경진 플랫폼. 실제 문제로 모델 성능을 겨루며 실습할 수 있습니다. 대회가 끝나면 우수 참가자의 코드와 풀이가 공개돼, 발표자료가 아니라 코드로 된 수상작을 읽는 곳입니다 — 파이썬으로 올라갈 때 본보기가 됩니다(수상작 서가는 발표 · 보고서 쪽).
빅콘테스트 — 과학기술정보통신부·NIA가 여는 국내 최대 빅데이터·AI 대회(2026년 제14회).
DataHack — 해커톤·스킬테스트 중심의 글로벌 챌린지 커뮤니티(Analytics Vidhya).
이론과 실습을 온라인 강의나 무료 전자책으로 더 다지고 싶다면 아래를 활용해 보세요.
- 파이썬 200제 (통계편) ↗ 위키독스에 무료로 공개된 파이썬 전자책. 통계를 파이썬 코드로 직접 풀어 보는 200개의 문제로 이뤄져 있어, 개념만 알고 손이 안 떨어지는 단계에서 쓰기 좋습니다. 위 파트 05의 파이썬과 파트 04의 기술 통계를 잇는 징검다리로 삼을 만합니다.
파트11현장 적용 — 호텔의 PMS와 빅데이터 RM앞의 예측 분석이 가장 또렷하게 작동하는 곳 — 호텔의 객실 가격 결정입니다.
- 데이터를 모으는 곳PMS — 자산관리시스템Property Management System. 호텔 운영의 중추. 예약·체크인/아웃·객실 배정·요금 청구·고객 관리를 한 곳에서 처리합니다. 최근에는 사내 서버형에서 클라우드 기반으로 옮겨가며 실시간 조회와 타 시스템 연동이 쉬워졌고, 무엇보다 거래·이용 데이터가 쌓이는 저수지 역할을 합니다.
- 데이터로 결정하는 곳RM — 수익경영Revenue Management. 쌓인 데이터에 경쟁사 가격·상권·SNS 트렌드·공공 데이터를 결합해 미래 수요를 예측하고, "적절한 방을 · 적절한 고객에게 · 적절한 시간에 · 적절한 가격으로" 파는 다이내믹 프라이싱을 구현합니다.
- 둘이 맞물릴 때PMS × RM의 시너지RM은 홀로 서지 않고 PMS와 연동됩니다. PMS에 축적된 고객의 과거 거래와 이용 패턴을 RM이 학습해 가격을 산출하는 구조입니다(예: PMS 데이터를 분석해 수익을 최적화하는 루넷 RMS 같은 솔루션). 목적은 하나 — 객실 이용률과 매출을 함께 끌어올리는 것입니다.
빅데이터가 실제 산업의 가격 결정을 어떻게 바꾸는지 보여주는 대표 사례가 호텔의 수익경영(Revenue Management, RM)입니다. 호텔 객실값은 수요·경쟁사·계절·검색 트렌드 같은 수많은 데이터로 실시간 조정되는데(다이내믹 프라이싱), 이는 이 모듈에서 배운 예측 분석이 현장에 적용된 좋은 예입니다.
- Vol.10 호텔산업 Pricing RM, 나아가야 할 방향은? ↗ 호텔 객실 가격을 데이터로 정하는 수익경영(RM)의 현황 — 자체·외부 RMS(IDeaS·Duetto 등)와 휴리스틱 방식, 그리고 생성형 AI가 바꿀 다이내믹 프라이싱의 미래를 다룬 리서치 브리프(국문·영문 PDF 제공).
- 호텔 시스템 도입 순서 가이드: PMS → 채널매니저 → CRM ↗ 호텔 디지털 전환(DX)의 실무 로드맵. PMS로 운영 기반을 다진 뒤 채널매니저·부킹엔진으로 매출을 넓히고, 마지막에 CRM으로 고객 충성도를 높이는 3단계 순서를 설명합니다. "순서를 잘못하면 비용이 더 든다"는 현장 조언.
- 호텔스토리 HUB — PMS(예약관리시스템) ↗ 엑셀 기반 예약 관리를 벗어난 클라우드형 PMS 솔루션의 실제 예. 채널매니저·부킹엔진 자동 연동으로 반복 업무를 줄이고, 객실 할당·요금 차등·입금 관리와 함께 매출 데이터 분석을 제공합니다.
파트12교재이 모듈이 손으로 직접 다루는 도구 — 파트 05의 Orange — 를 처음부터 끝까지 따라가며 익히는 책입니다.
- 「오렌지3로 쉽게 배우는 머신러닝과 데이터 분석」[개정판] — 장원두 외 지음 ↗ 코딩 없이 드래그 앤 드롭으로 전처리 → 분석 → 시각화까지 — 파트 05의 Orange를 처음부터 끝까지 따라가는 15주 구성. 1장 오렌지·노코딩·머신러닝 · 2장 오렌지 기초와 기초 통계 분석 · 3장 데이터 시각화 · 4장 데이터 전처리 · 5장 비지도 학습과 데이터 분석 · 6장 지도 학습과 데이터 분류 · 7장 딥러닝과 이미지 분류 · 8장 자연어 처리 · 9장 시계열 데이터 분석.
- 「제대로 알고 쓰는 논문 통계분석」[개정증보판] — 노경섭 지음 ↗ 파트 05의 SPSS · 노경섭 영상 강좌와 바로 이어지는 교재 — 1부 논문 통계분석의 기초(가설 · 유의수준 · 척도 · 자료수집 · 표본추출) · 2부 SPSS를 이용한 통계분석(기술통계 · t검정 · ANOVA · 요인분석 · 회귀분석 · 군집분석) · 3부 AMOS를 이용한 구조방정식모델(확인적 요인분석 · 경로분석 · 다중집단분석). 이론보다 결과 해석에 무게를 둡니다.
이 웹사이트도 작은 데이터 파이프라인을 갖고 있습니다 — 여행 이야기·후기 게시판은 감성 분석의 재료(UGC)이고, 방문 통계·검색 유입은 어떤 콘텐츠가 닿는지를 알려줍니다. 이 데이터를 읽고 상품과 콘텐츠로 바꾸는 일 — 그 끝에 있는 것이 다음 모듈 관광벤처창업론입니다.